
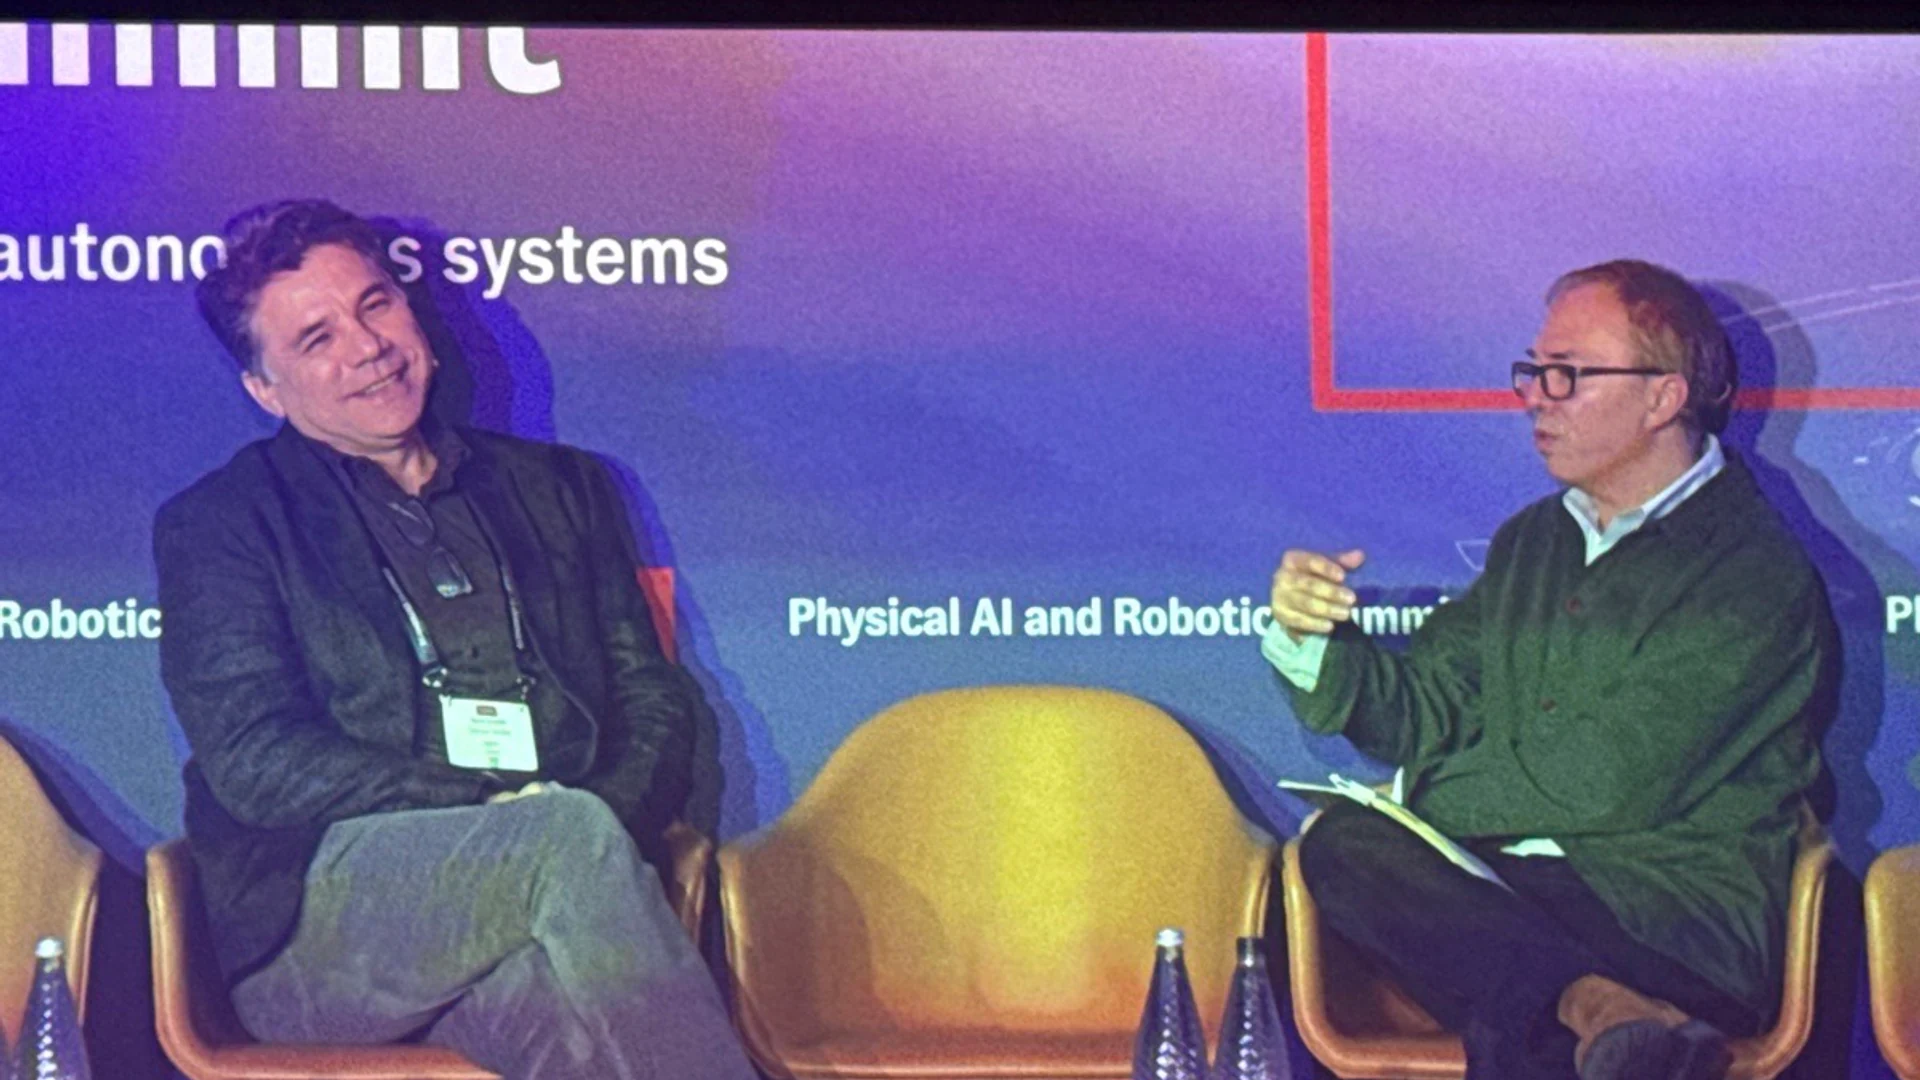
Por mais de meio século, o progresso da computação obedeceu à lei de Moore: colocar o dobro de transistores no silício a cada dezoito a vinte e quatro meses. Mas no campo emergente da IA física e da robótica autônoma, a lei de Moore colidiu com as leis da termodinâmica. Drones autônomos, robôs quadrúpedes, manipuladores cirúrgicos e veículos autônomos não conseguem carregar GPUs de classe servidor de 700 watts nem torres de resfriamento. Na cúpula Physical AI and Robotics da Economist Enterprise, em Londres, em 13 de outubro de 2026, Taner Ozcelik, presidente do conselho e CEO da Mythic AI, conversou com Kenneth Cukier num bate-papo informal sobre a revolução arquitetônica necessária para sair desse impasse: ir além da lei de Moore com a computação analógica em memória (CIM) e os chiplets modulares.
O muro termodinâmico: por que a IA física não pode viver na nuvem #
Na sessão intitulada Moving past Moore’s law: the power behind high-performance robotics, Kenneth Cukier apresentou o dilema de engenharia central da autonomia corporativa: os modelos de inteligência artificial crescem em número de parâmetros e em capacidade de percepção, mas as máquinas físicas operam sob restrições SWaP-C implacáveis (tamanho, peso, potência e custo).
A fronteira atual da IA está ancorada em data centers de hiperescala que consomem 150 megawatts ou mais em enormes clusters de servidores. Como apontou Ozcelik, essa arquitetura opera em escalas de energia milhões de vezes distantes das referências biológicas. O cérebro humano faz em tempo real a coordenação sensório-motora contínua, o raciocínio semântico e a navegação visuoespacial com um orçamento metabólico de cerca de 20 watts.
Historicamente, os engenheiros de robótica tentaram contornar os limites da computação embarcada levando a inferência para a nuvem. Mas em ambientes industriais, aeroespaciais e de defesa de missão crítica, a autonomia dependente da nuvem é uma impossibilidade arquitetônica:
- Variação de latência e jitter: o controle robótico em malha fechada de alta velocidade exige atualizações determinísticas dos motores entre 50 Hz e 1.000 Hz (idas e voltas abaixo de 20 milissegundos). Redes celulares e Wi-Fi introduzem jitter, quadros perdidos e picos de latência que fazem braços robóticos derrubarem peças ou veículos autônomos perderem os limites de frenagem.
- Saturação da largura de banda: transmitir vários fluxos de vídeo 4K sem compressão e nuvens de pontos LiDAR de dezenas de robôs móveis numa fábrica esgota rapidamente a largura de banda de rádio local e gera tarifas de saída da nuvem exorbitantes.
- Soberania operacional e conectividade disputada: na mineração subterrânea, em túneis sem GPS, em canteiros de obras remotos ou em ambientes militares táticos, os links de rede externos não existem ou sofrem interferência ativa. Os sistemas autônomos precisam carregar toda a sua inteligência operacional diretamente no chassi da borda.
Equipar robôs com GPUs padrão de alto desempenho traz suas próprias penalidades físicas: estrangulamento térmico, dissipadores enormes que acrescentam massa parasita à carga útil e um consumo elevado que reduz o tempo de voo de horas para minutos.
A tese arquitetônica: computação em memória (CIM) #
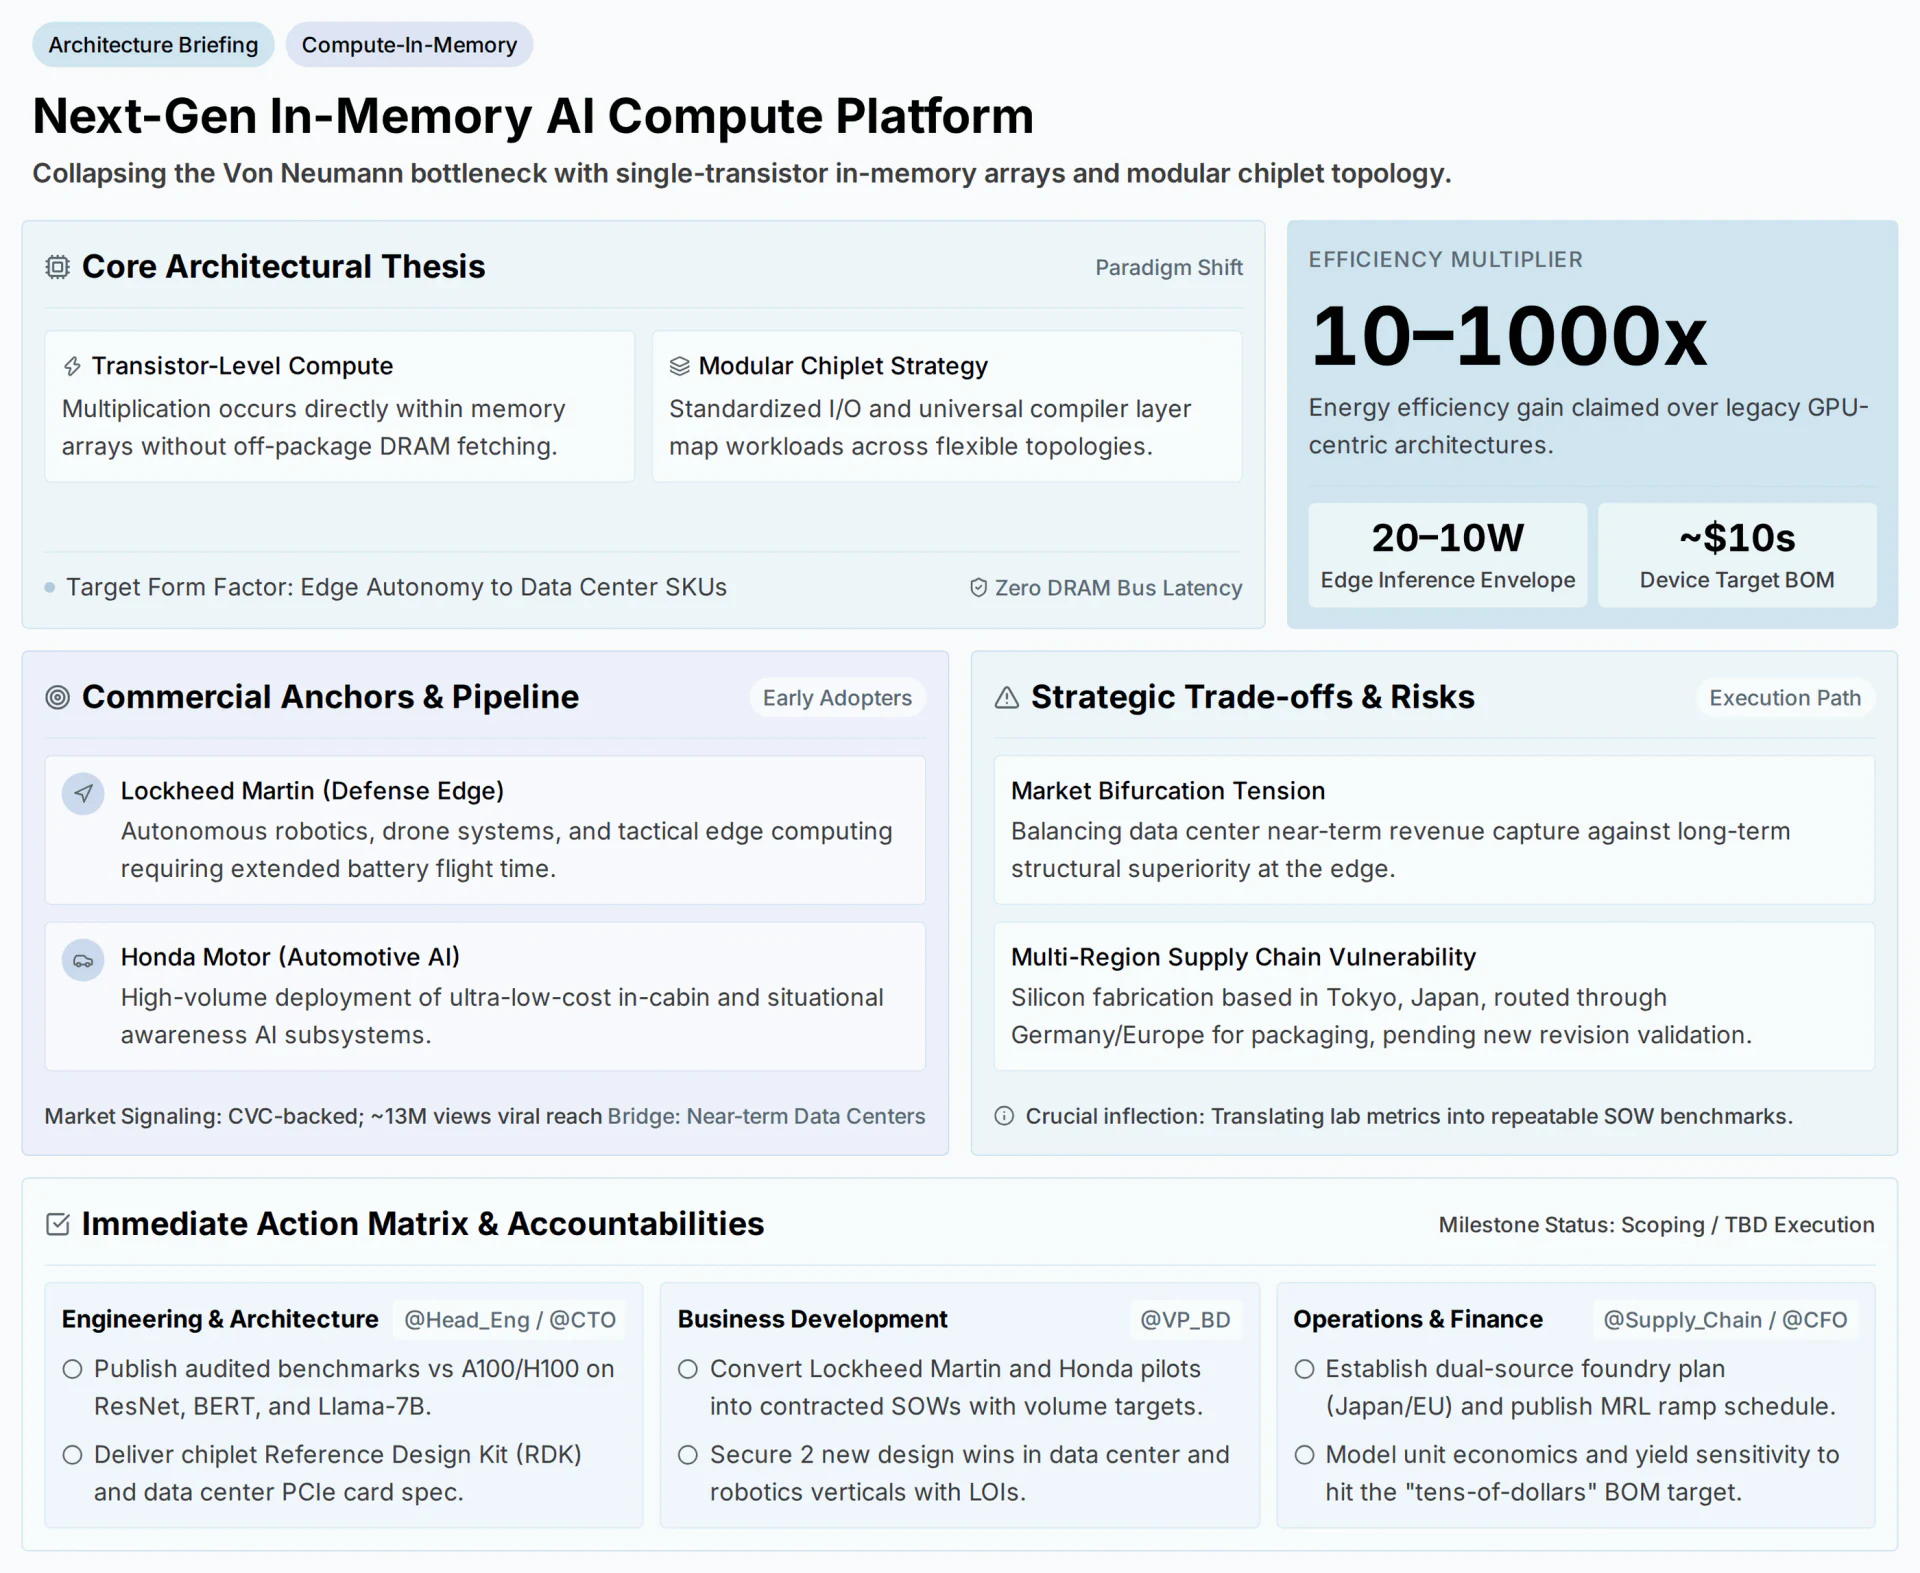
Para resolver o gargalo termodinâmico, a Mythic AI defende uma filosofia arquitetônica: em vez de transportar dados entre unidades de processamento e bancos de memória separados, a própria memória deve se tornar o computador.
 .class="img-fluid clearfix"
A física da multiplicação de matrizes com um único transistor #
Na computação digital clássica, calcular um produto escalar de matrizes exige buscar milhares de pesos de 8 ou 16 bits numa DRAM externa por linhas de barramento de alta capacitância, carregá-los em registradores de cache, fazer a multiplicação em ULAs digitais e gravar os resultados de volta na memória. Mais de 90% da energia é gasta carregando e descarregando as interconexões de cobre entre os chips.
As arquiteturas de computação em memória substituem essa transferência digital de dados pela física dos circuitos analógicos:
Programação dos pesos. Os pesos da rede neural são programados diretamente em células de memória não volátil (como flash modificada ou RAM resistiva) na forma de condutâncias analógicas ($G$). Uma vez programados, os pesos ficam parados dentro da matriz de memória; nunca são buscados nem transferidos durante a inferência.
Modulação da tensão de entrada. As ativações de entrada (como tokens visuais vindos das câmeras) são convertidas em níveis de tensão analógicos ($V$) e aplicadas às linhas de palavra da matriz.
Multiplicação pela lei de Ohm. Quando a tensão de entrada passa por cada célula de memória, a lei de Ohm ($I = V \times G$) faz uma multiplicação analógica instantânea e gera uma corrente proporcional ao produto da entrada pelo peso armazenado.
Acumulação pela lei das correntes de Kirchhoff. Ao longo das linhas de bit verticais, as correntes de milhares de células em paralelo se somam naturalmente segundo a lei das correntes de Kirchhoff ($\sum I = 0$).
Assim, uma única matriz de memória flash executa uma multiplicação matriz-vetor completa em um único ciclo de clock, no nível da física e sem um único acesso à memória. A corrente analógica acumulada é então convertida de volta em valores digitais por conversores analógico-digitais (ADCs) de alta velocidade na borda da matriz.
A estratégia de chiplets modulares #
Embora a computação analógica em memória resolva as equações de energia e latência, levar o silício a setores comerciais muito diferentes exige flexibilidade de encapsulamento. Em vez de fabricar grandes sistemas em chip (SoCs) monolíticos, que sofrem com taxas de defeito exponenciais, baixo rendimento por wafer e configurações de produto rígidas, Ozcelik apresentou uma estratégia de chiplets modulares.
Nesse paradigma, pequenos blocos padronizados de computação em memória são fabricados de forma independente e unidos sobre interposers com encapsulamento avançado:
- Interconexões padronizadas de alta velocidade entre chips: com base em padrões emergentes como o Universal Chiplet Interconnect Express (UCIe), os chiplets se comunicam por microbumps com alta densidade de largura de banda e latências na casa dos picossegundos.
- Composição heterogênea: um projetista pode combinar dois chiplets em memória com um processador de controle ARM de baixo custo para a carga útil de um drone leve, ou montar dezesseis chiplets com interfaces PCIe de alta velocidade para criar uma placa aceleradora de servidor para data centers de borda.
- Compilação universal e distribuição de cargas: uma camada de compilação unificada recebe grafos padrão de aprendizado profundo (ONNX, PyTorch) e distribui automaticamente as camadas do modelo pela topologia de chiplets disponível, otimizando o roteamento de dados para minimizar a comunicação entre chiplets.
Comparação arquitetônica: paradigmas de computação para a robótica na borda #
| Vetor arquitetônico | GPU digital padrão (NVIDIA Jetson / Orin) | NPU de borda dedicada (Google Coral / Hailo) | Chiplet de computação analógica em memória (Mythic AI) |
|---|---|---|---|
| Mecanismo subjacente | Núcleos digitais SIMD/tensoriais que buscam pesos em LPDDR5/HBM | Matrizes sistólicas digitais com cache de pesos em SRAM no chip | Matrizes analógicas de um único transistor que multiplicam matrizes in situ |
| Custo da movimentação de dados | Alto (carga contínua dos barramentos DRAM/SRAM; mais de 85% de energia desperdiçada) | Moderado (limitado pela capacidade do cache SRAM interno) | Nenhuma movimentação interna de dados; os pesos ficam permanentemente na memória |
| Envelope de potência de inferência | De 30 W a mais de 75 W (exige ventoinhas ativas e dissipadores pesados) | De 5 W a 15 W (resfriamento passivo ou mínimo) | De 10 W a 20 W (dissipação térmica passiva ultracompacta) |
| Eficiência energética (TOPS/W) | De 2 a 5 TOPS/watt (no nível do sistema) | De 10 a 25 TOPS/watt | De 50 a mais de 200 TOPS/watt (eficiência teórica de 10x a 1.000x) |
| Lista de materiais do componente (BOM) | De £ 500 a mais de £ 2.500 por módulo de computação | De £ 100 a £ 350 por placa aceleradora | Algumas dezenas de dólares por chiplet em volume |
| Gargalo de memória (Von Neumann) | Grave; limitado pela largura de banda da memória (GB/s a TB/s) | Moderado; limitado pela capacidade da SRAM no chip (MB) | Inexistente; a largura de banda da matriz é a da matriz de memória interna |
| Domínio de implantação | Veículos autônomos premium e robôs de inspeção industrial | Câmeras inteligentes e dispositivos IoT embarcados leves | Robótica tátil de alta taxa, drones táticos e IA automotiva |
Fonte: síntese dos dados da conversa e das especificações de arquitetura de semicondutores apresentadas na cúpula Physical AI and Robotics da Economist Enterprise (Convene 200 Aldersgate, Londres, 13 de outubro de 2026).
O que isso significa por setor #
A validação comercial da computação em memória depende de sua entrada em setores nos quais as restrições de potência e custo vêm bloqueando a implantação de modelos de fundação avançados.
Defesa tática e sistemas não tripulados #
Nas aplicações de defesa na borda, a eficiência energética se traduz diretamente em capacidade de sobrevivência operacional e duração da missão. Pequenos sistemas aéreos não tripulados (sUAS) e veículos terrestres táticos são fortemente limitados pelo peso da bateria. Equipar um drone de reconhecimento com uma GPU convencional reduz sua autonomia de voo em 30% a 50% apenas para alimentar a pilha de percepção de IA.
O trabalho estratégico da Mythic AI com a Lockheed Martin se concentra em integrar a computação em memória a sistemas táticos de borda, enxames de drones autônomos e postos de vigilância remotos. Ao reduzir o consumo de computação de 50 W para menos de 10 W, os drones táticos ganham tempo de voo enquanto executam localmente a classificação multimodal de objetos, o processamento de sinais de guerra eletrônica e a odometria visual-inercial, em teatros de operação disputados e sem GPS.
Percepção do entorno e IA de cabine no setor automotivo #
No setor automotivo, os fornecedores de primeira linha enfrentam forte pressão sobre as margens. Enquanto os veículos elétricos topo de linha conseguem absorver o custo de computadores de direção autônoma com resfriamento líquido de £ 2.000, os veículos de massa não conseguem.
A parceria da Honda Motor com a Mythic AI ataca esse atrito comercial. As montadoras precisam de chips de IA qualificados para uso automotivo, em alto volume e custando dezenas de dólares em vez de centenas, capazes de rodar o monitoramento do motorista, a segmentação de objetos no ponto cego e a percepção de 360 graus sem circuitos complexos de resfriamento líquido que aumentam o custo de fabricação e a complexidade de montagem.
Data centers industriais de borda e logística móvel #
Embora a computação em memória seja otimizada para a borda, a Mythic executa uma estratégia deliberada de ponte ao oferecer placas aceleradoras PCIe para data centers de borda e centros de distribuição. Em instalações com centenas de robôs móveis autônomos (AMRs), os racks de servidores que rodam os modelos de coordenação da frota são limitados pela entrada de energia e pela capacidade de resfriamento do local. As placas aceleradoras em memória permitem multiplicar a vazão de inferência local sem ampliar a infraestrutura elétrica.
Resiliência da cadeia de suprimentos e geografia da fabricação #
Uma parte crucial da apresentação de Ozcelik tratou da soberania da cadeia de suprimentos. A inovação em hardware não tem sentido se o silício não puder ser fabricado, encapsulado e enviado de forma confiável e em escala.
A Mythic AI montou uma base de fabricação internacional distribuída:
- Fabricação do silício: a produção dos wafers de computação em memória está ancorada em Tóquio, no Japão, aproveitando a liderança consolidada do país na fabricação de semicondutores de precisão e em nós de processo analógicos e flash maduros.
- Encapsulamento avançado e montagem: os wafers seguem para a Europa (mais precisamente para a Alemanha) para o corte avançado dos chiplets, a ligação a substratos com vários chips e a inspeção óptica automatizada.
- Validação da revisão: a empresa está concluindo a validação de sua mais recente revisão de silício, com foco em transformar as métricas de rendimento de laboratório em escopos de trabalho (SOWs) repetíveis e de padrão de produção para os volumes automotivo e de defesa.
Essa abordagem em várias regiões evita vulnerabilidades geopolíticas de ponto único e oferece aos parceiros corporativos europeus e asiáticos cadeias de suprimentos geograficamente diversificadas.
Conclusão #
A conversa entre Taner Ozcelik e Kenneth Cukier na cúpula Physical AI and Robotics da Economist Enterprise delineou a realidade física que vai reger a próxima década de sistemas autônomos. A lei de Moore, como simples métrica de escalonamento de transistores, já não basta para impulsionar a revolução da IA física.
Enquanto as arquiteturas de computação se apegarem à separação de Von Neumann entre lógica e memória, a robótica continuará limitada pela massa das baterias, pela dissipação de calor e por custos de lista de materiais proibitivos. Ao passar da movimentação digital de dados para matrizes analógicas de computação em memória e topologias de chiplets modulares, a engenharia de semicondutores está entregando o salto de eficiência de que os sistemas autônomos precisam.
A transição de clusters de data center de 700 W para silício de borda de 15 W é a verdadeira porta de entrada para a autonomia física. Em última análise, robôs que operam no mundo real precisam obedecer às leis energéticas do mundo real; a computação em memória é a arquitetura que faz a ponte entre o silício e a biologia.
Perguntas frequentes #
O que é o gargalo de Von Neumann no hardware de IA? O gargalo de Von Neumann é o limite de vazão e de energia causado pela separação física entre a unidade de processamento (ULA) e a memória do sistema (DRAM). Nas cargas de inteligência artificial, que envolvem bilhões de multiplicações de matrizes, os processadores gastam mais de 85% da energia total e muitos ciclos de clock só para levar e trazer dados por barramentos de cobre, o que cria graves gargalos térmicos e de latência.
Como funciona a computação analógica em memória (CIM)? A computação em memória faz as operações matemáticas diretamente dentro das células de memória, sem mover dados. Os pesos da rede neural ficam armazenados como estados de condutância analógica em células de memória não volátil. Quando tensões de entrada são aplicadas à matriz, a corrente passa pelas células segundo a lei de Ohm ($I = V \times G$) e se soma ao longo das linhas de bit segundo a lei das correntes de Kirchhoff. Isso realiza uma multiplicação matriz-vetor completa em um único passo físico.
Por que a computação em memória é tão importante para robôs e drones? Robôs móveis e drones operam sob limites estritos de tamanho, peso, potência e custo (SWaP-C). Dependem de baterias embarcadas e não comportam radiadores pesados nem fontes de alta potência. A computação em memória oferece eficiência energética de 10 a 1.000 vezes maior, o que permite aos robôs rodar localmente modelos complexos de visão-linguagem-ação dentro de um envelope de 10 W a 20 W, preservando a autonomia da bateria.
Qual é a vantagem dos chiplets em relação a um chip monolítico? Chips monolíticos integram todas as unidades funcionais num único die de silício de grande porte. À medida que o die cresce, a taxa de defeitos de fabricação aumenta exponencialmente, o que reduz o rendimento da produção e eleva o custo unitário. Uma arquitetura de chiplets divide o sistema em dies de silício menores e padronizados, fabricados de forma independente com alto rendimento e conectados por microbumps de alta velocidade. Isso permite configurações modulares e flexíveis, ajustadas a requisitos industriais específicos de potência e formato.
Quem são os principais parceiros comerciais dessa tecnologia? A plataforma de computação em memória da Mythic AI se apoia hoje em duas grandes parcerias corporativas: a Lockheed Martin, que está integrando a arquitetura a drones de defesa tática, plataformas robóticas não tripuladas e postos de segurança de perímetro para ampliar a autonomia das baterias; e a Honda Motor, que busca chips de IA de baixo custo e qualificados para uso automotivo, voltados à percepção do entorno do veículo e ao sensoriamento da cabine.
Referências #
- Economist Enterprise, (2026). Cúpula Physical AI & Robotics: vantagem operacional com sistemas autônomos ⧉. Economist Enterprise.
- Ozcelik, T., (2026). Além da lei de Moore: a energia por trás da robótica de alto desempenho ⧉. Mythic AI.
- Cukier, K., (2026). Os tetos termodinâmicos da inteligência autônoma ⧉. The Economist.
- Marković, D., Mizrahi, A., Querlioz, D., e Grollier, J., (2020). Física para a computação neuromórfica ⧉. Nature Reviews Physics, 2, 499-510.
- Universal Chiplet Interconnect Express, (2025). Especificação UCIe 2.0: padrão de interconexão entre chips ⧉. UCIe Consortium.
- IEEE, (2026). International Roadmap for Devices and Systems (IRDS): além do CMOS e da computação em memória ⧉. IEEE Standards Association.
Última revisão .
Última revisão .
Republicar este artigo
Copiar formato para Medium
# Computação em memória e chiplets: a robótica além da lei de Moore — Sebastien Rousseau

> Originally published at [https://sebastienrousseau.com/pt-br/2026-10-13-computacao-em-memoria-chiplets-robotica-alem/](https://sebastienrousseau.com/pt-br/2026-10-13-computacao-em-memoria-chiplets-robotica-alem/)

Na cúpula Physical AI and Robotics da Economist Enterprise, Taner Ozcelik (Mythic AI) mostrou como a computação em memória e os chiplets derrubam o muro da memória.

Read the full article on sebastienrousseau.com: https://sebastienrousseau.com/pt-br/2026-10-13-computacao-em-memoria-chiplets-robotica-alem/
Copiar formato para Mastodon
Computação em memória e chiplets: a robótica além da lei de Moore — Sebastien Rousseau

Na cúpula Physical AI and Robotics da Economist Enterprise, Taner Ozcelik (Mythic AI) mostrou como a computação em memória e os chiplets derrubam o muro da memória.

https://sebastienrousseau.com/pt-br/2026-10-13-computacao-em-memoria-chiplets-robotica-alem/
Copiar formatado para o LinkedIn
Computação em memória e chiplets: a robótica além da lei de Moore — Sebastien Rousseau

Na cúpula Physical AI and Robotics da Economist Enterprise, Taner Ozcelik (Mythic AI) mostrou como a computação em memória e os chiplets derrubam o muro da memória.

Estes são os principais aprendizados estratégicos:

- O muro termodinâmico: por que a IA física não pode viver na nuvem. Na sessão intitulada Moving past Moore’s law: the power behind high-performance robotics, Kenneth Cukier apresentou o dilema de engenharia central da autonomia corporativa: os modelos de inteligência artificial…
- A tese arquitetônica: computação em memória (CIM). Para resolver o gargalo termodinâmico, a Mythic AI defende uma filosofia arquitetônica: em vez de transportar dados entre unidades de processamento e bancos de memória separados, a própria memória deve se tornar o…
- A estratégia de chiplets modulares. Embora a computação analógica em memória resolva as equações de energia e latência, levar o silício a setores comerciais muito diferentes exige flexibilidade de encapsulamento.
- Comparação arquitetônica: paradigmas de computação para a robótica na borda. Fonte: síntese dos dados da conversa e das especificações de arquitetura de semicondutores apresentadas na cúpula Physical AI and Robotics da Economist Enterprise (Convene 200 Aldersgate, Londres, 13 de outubro de 2026).

Qual é a abordagem da sua organização em relação aos desafios descritos neste artigo?

→ https://sebastienrousseau.com/pt-br/2026-10-13-computacao-em-memoria-chiplets-robotica-alem/

#ComputaçãoEmMemória #MythicAi #TanerOzcelik #LeiDeMoore #GargaloDeVonNeumann

Sebastien Rousseau | CC-BY-4.0
Citar este artigo
Computação em memória e chiplets: a robótica além da lei de Moore — Sebastien Rousseau
Na cúpula Physical AI and Robotics da Economist Enterprise, Taner Ozcelik (Mythic AI) mostrou como a computação em memória e os chiplets derrubam o muro da memória.
BibTeX
@online{rousseau2026computação,
  author  = {Rousseau, Sebastien},
  title   = {{Computação em memória e chiplets: a robótica além da lei de Moore — Sebastien Rousseau}},
  year    = {2026},
  url     = {https://sebastienrousseau.com/pt-br/2026-10-13-computacao-em-memoria-chiplets-robotica-alem/},
  urldate = {2026}
}RIS
TY  - GEN
AU  - Rousseau, Sebastien
TI  - Computação em memória e chiplets: a robótica além da lei de Moore — Sebastien Rousseau
PY  - 2026
UR  - https://sebastienrousseau.com/pt-br/2026-10-13-computacao-em-memoria-chiplets-robotica-alem/
ER  -
Vancouver
Rousseau S. Computação em memória e chiplets: a robótica além da lei de Moore — Sebastien Rousseau. sebastienrousseau.com. 2026 Oct 13. Available from: https://sebastienrousseau.com/pt-br/2026-10-13-computacao-em-memoria-chiplets-robotica-alem/
Chicago
Rousseau, Sebastien. "Computação em memória e chiplets: a robótica além da lei de Moore — Sebastien Rousseau." sebastienrousseau.com. October 13, 2026. https://sebastienrousseau.com/pt-br/2026-10-13-computacao-em-memoria-chiplets-robotica-alem/.
APA
Rousseau, S. (2026, October 13). Computação em memória e chiplets: a robótica além da lei de Moore — Sebastien Rousseau. sebastienrousseau.com. https://sebastienrousseau.com/pt-br/2026-10-13-computacao-em-memoria-chiplets-robotica-alem/
Republicar este artigo
Computação em memória e chiplets: a robótica além da lei de Moore — Sebastien Rousseau
Na cúpula Physical AI and Robotics da Economist Enterprise, Taner Ozcelik (Mythic AI) mostrou como a computação em memória e os chiplets derrubam o muro da memória.
Este artigo está licenciado sob Creative Commons Attribution 4.0 International. A republicação exige atribuição à URL canônica.
Computação em memória e chiplets: a robótica além da lei de Moore — Sebastien Rousseau

Na cúpula Physical AI and Robotics da Economist Enterprise, Taner Ozcelik (Mythic AI) mostrou como a computação em memória e os chiplets derrubam o muro da memória.

Originally published at https://sebastienrousseau.com/pt-br/2026-10-13-computacao-em-memoria-chiplets-robotica-alem/ by Sebastien Rousseau.
Licensed under CC-BY-4.0.