
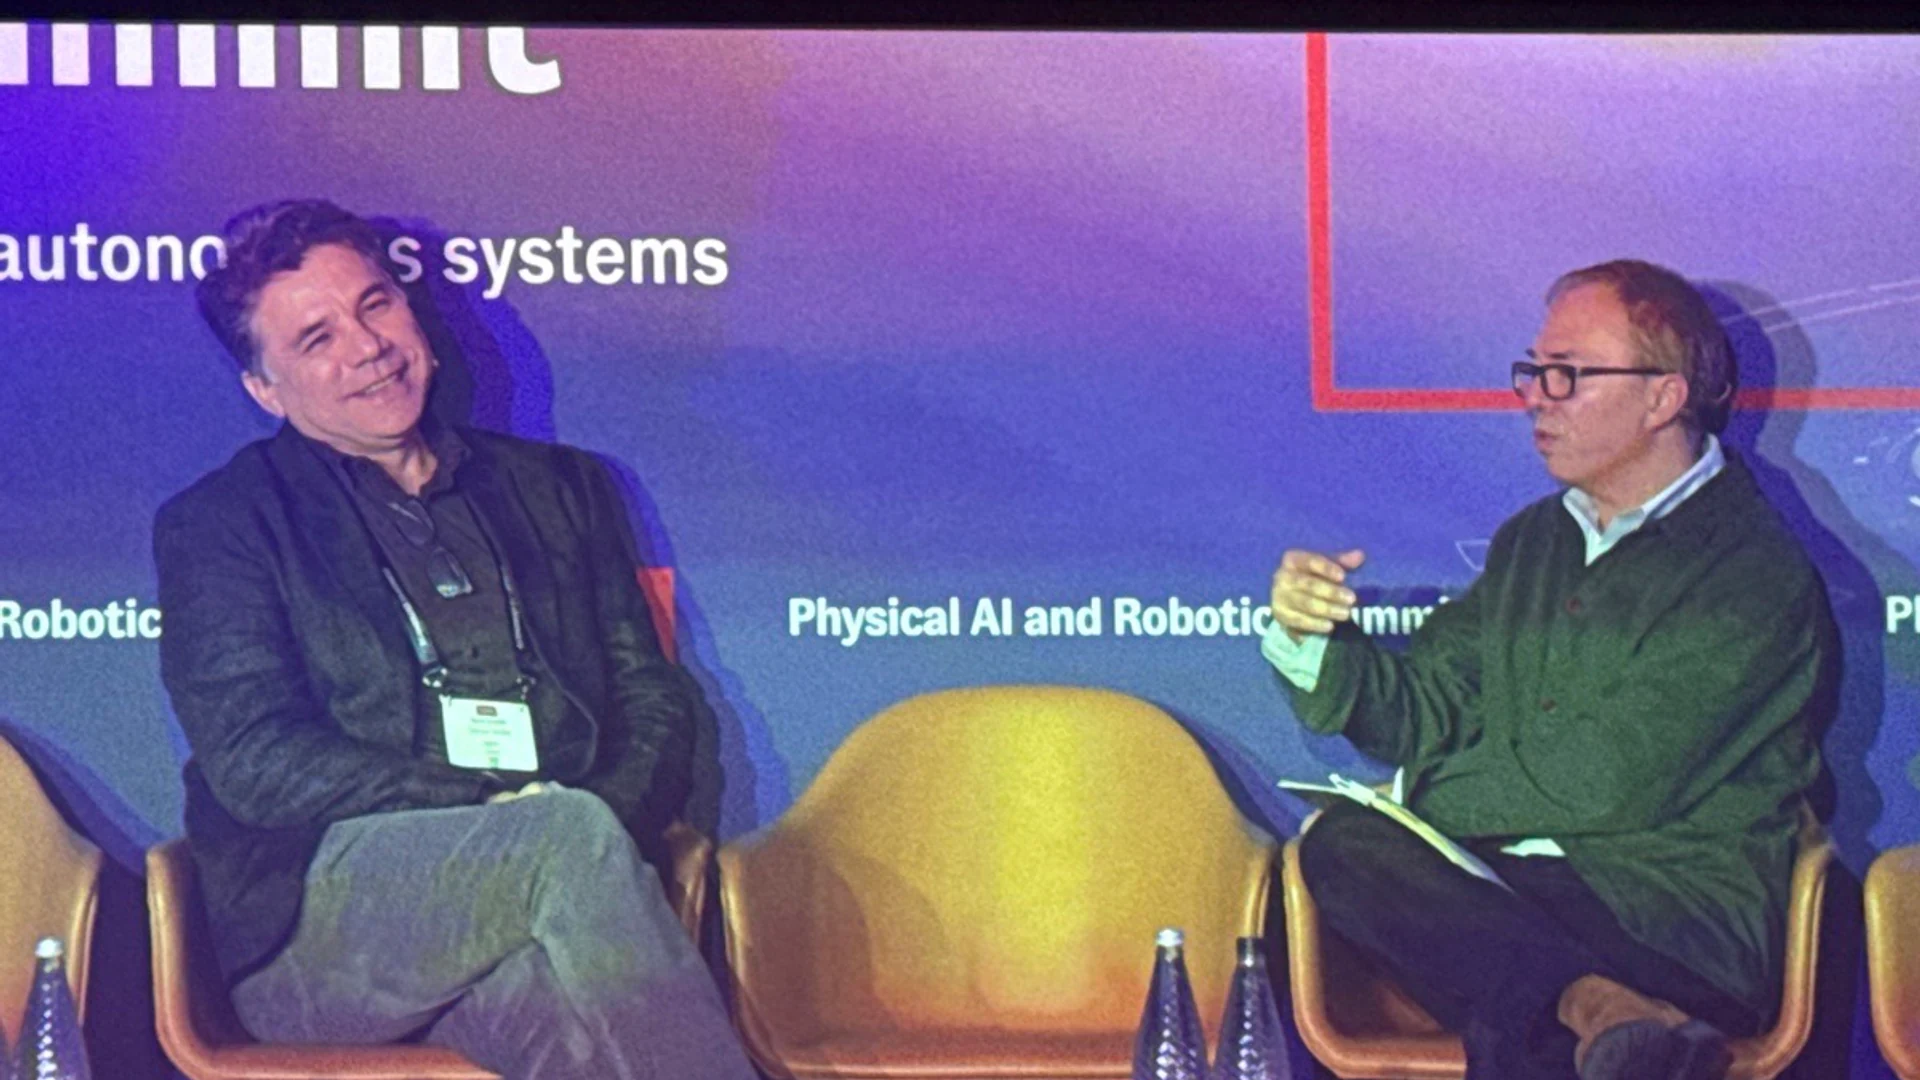
Durante más de medio siglo, el progreso de la computación obedeció a la ley de Moore: meter el doble de transistores en el silicio cada dieciocho a veinticuatro meses. Pero en el campo emergente de la IA física y la robótica autónoma, la ley de Moore ha chocado con las leyes de la termodinámica. Los drones autónomos, los robots cuadrúpedos, los manipuladores quirúrgicos y los vehículos autónomos no pueden cargar con GPU de clase servidor de 700 vatios ni con torres de refrigeración. En la cumbre Physical AI and Robotics de Economist Enterprise, celebrada en Londres el 13 de octubre de 2026, Taner Ozcelik, presidente y consejero delegado de Mythic AI, conversó con Kenneth Cukier junto a la chimenea sobre la revolución arquitectónica necesaria para salir de este punto muerto: ir más allá de la ley de Moore mediante el cómputo analógico en memoria (CIM) y los chiplets modulares.
El muro termodinámico: por qué la IA física no puede vivir en la nube #
En la sesión titulada Moving past Moore’s law: the power behind high-performance robotics, Kenneth Cukier planteó el dilema de ingeniería central de la autonomía empresarial: los modelos de inteligencia artificial crecen en número de parámetros y en capacidad de percepción, pero las máquinas físicas operan bajo restricciones SWaP-C implacables (tamaño, peso, potencia y coste).
La frontera actual de la IA se asienta en centros de datos de hiperescala que consumen 150 megavatios o más en enormes clústeres de servidores. Como señaló Ozcelik, esta arquitectura funciona a escalas de energía millones de veces alejadas de las referencias biológicas. El cerebro humano realiza en tiempo real la coordinación sensoriomotora continua, el razonamiento semántico y la navegación visoespacial con un presupuesto metabólico de unos 20 vatios.
Históricamente, los ingenieros de robótica intentaron sortear los límites del cómputo a bordo trasladando la inferencia a la nube. Sin embargo, en entornos industriales, aeroespaciales y de defensa de misión crítica, la autonomía dependiente de la nube es una imposibilidad arquitectónica:
- Variabilidad de la latencia y jitter: el control robótico en lazo cerrado de alta velocidad exige actualizaciones deterministas de los motores entre 50 Hz y 1000 Hz (viajes de ida y vuelta de menos de 20 milisegundos). Las redes móviles y wifi introducen jitter, fotogramas perdidos y picos de latencia que hacen que los brazos robóticos suelten piezas o que los vehículos autónomos no alcancen los umbrales de frenado.
- Saturación del ancho de banda: transmitir varias señales de vídeo 4K sin comprimir y nubes de puntos LiDAR desde decenas de robots móviles en una planta industrial agota pronto el ancho de banda de radio local e implica tarifas de salida de la nube desorbitadas.
- Soberanía operativa y conectividad disputada: en la minería subterránea, los túneles sin GPS, las obras remotas o los entornos militares tácticos, los enlaces de red externos no existen o están bloqueados de forma activa. Los sistemas autónomos deben llevar toda su inteligencia operativa directamente en el chasis del borde.
Equipar a los robots con GPU de alto rendimiento estándar tiene sus propias penalizaciones físicas: limitación térmica, disipadores enormes que añaden masa parásita a la carga útil y un consumo elevado que reduce el tiempo de vuelo de horas a minutos.
La tesis arquitectónica: el cómputo en memoria (CIM) #
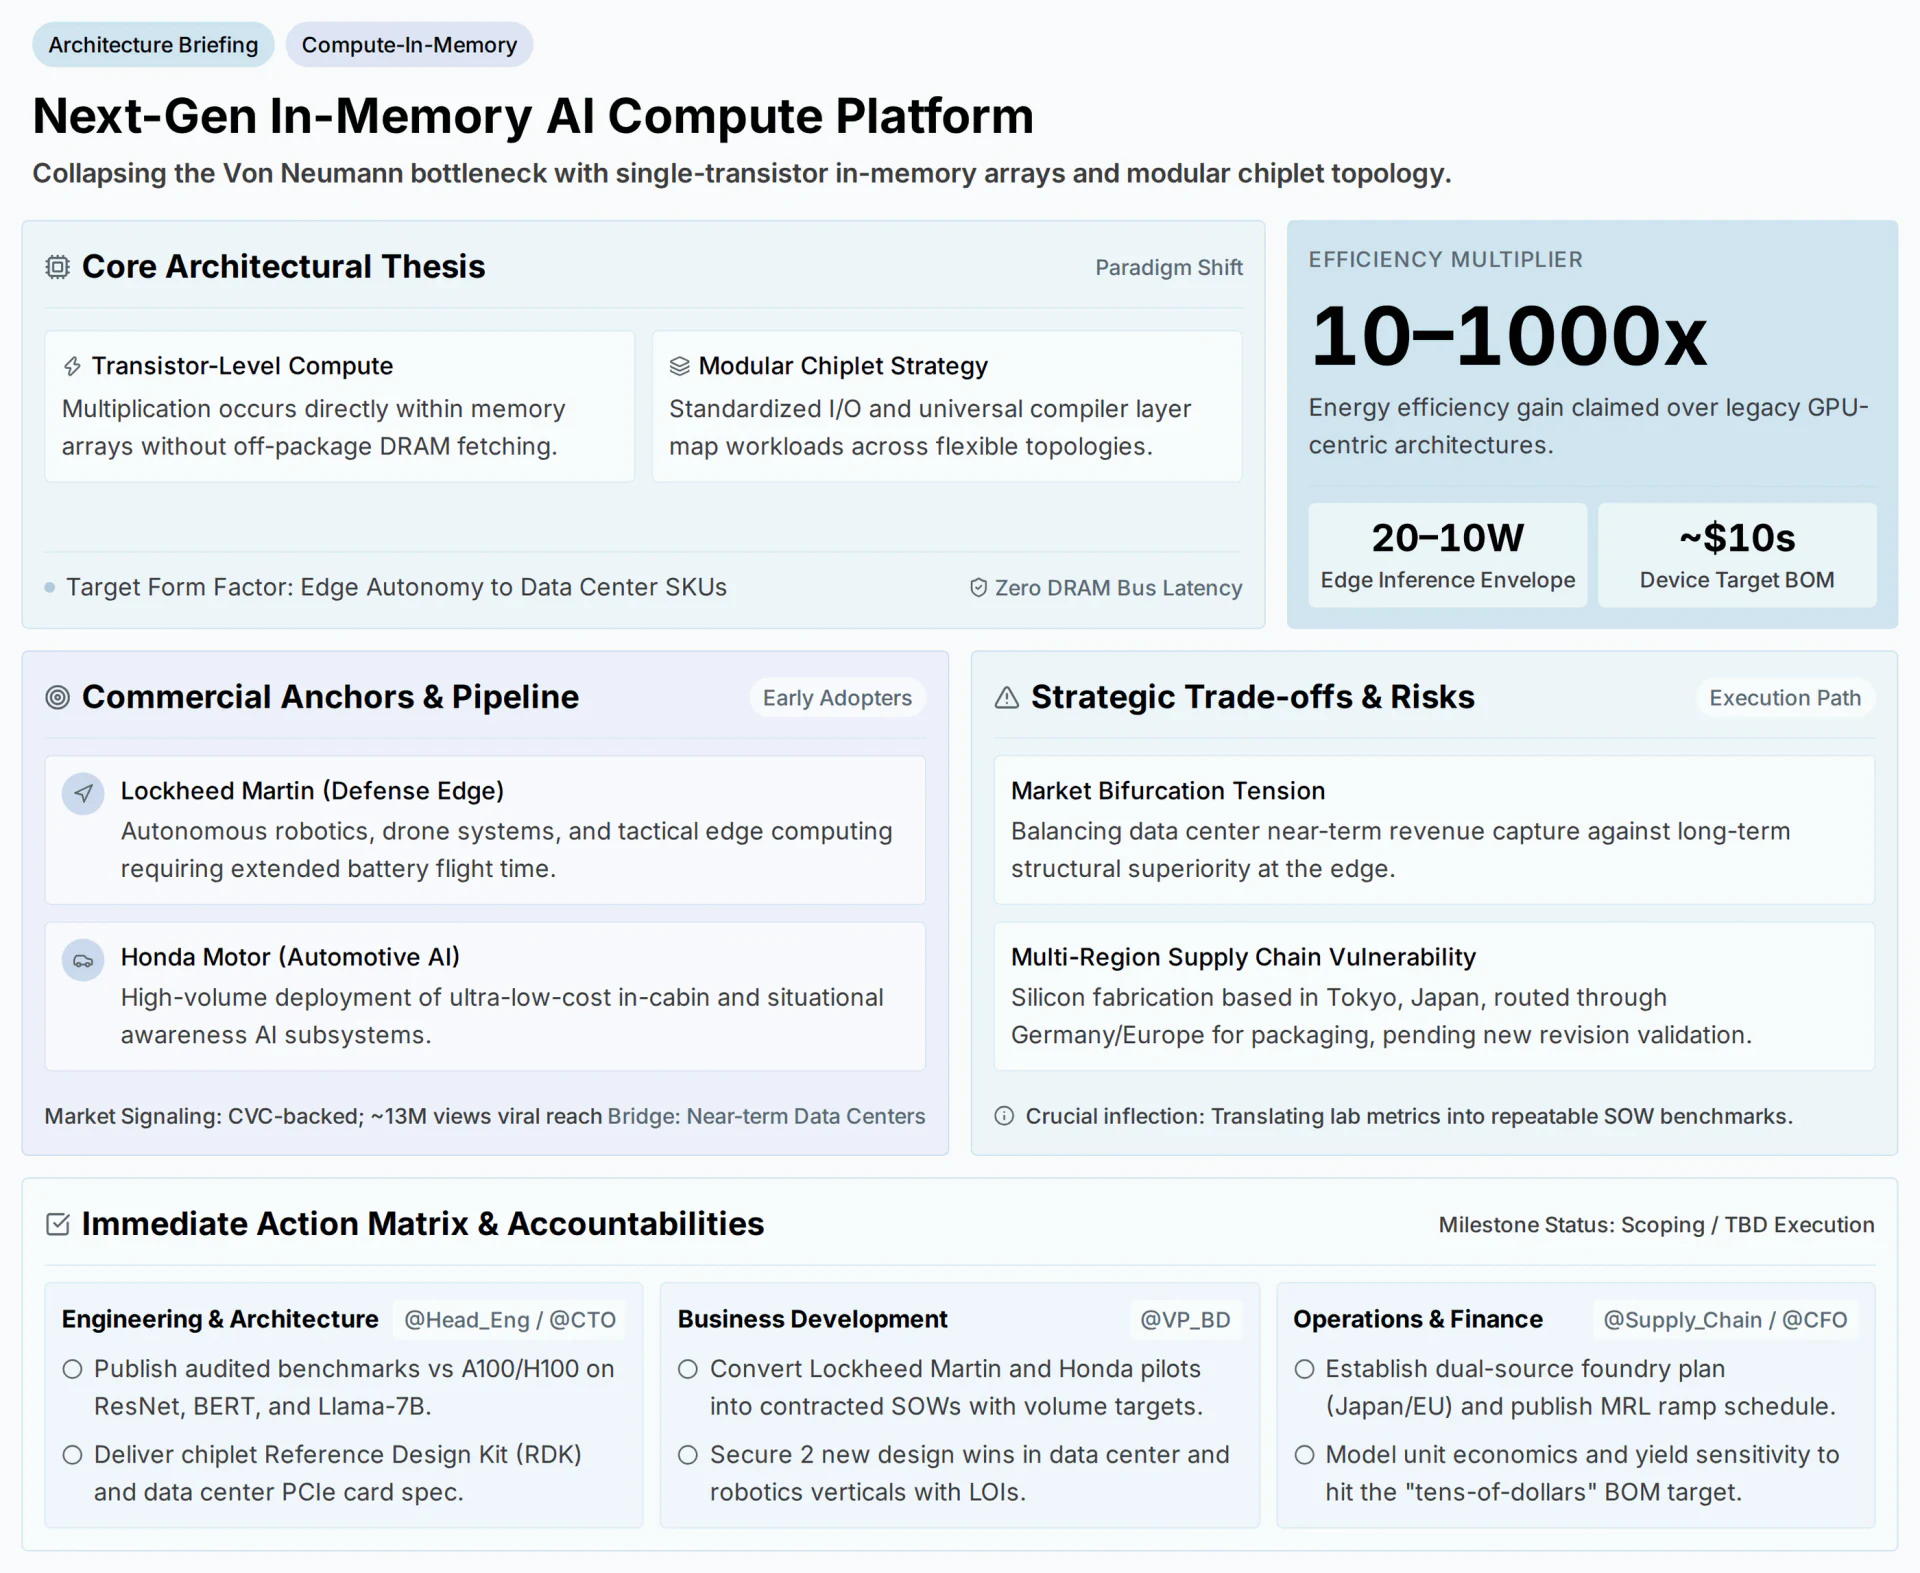
Para resolver el cuello de botella termodinámico, Mythic AI defiende una filosofía arquitectónica: en lugar de trasladar datos entre unidades de procesamiento y reservas de memoria separadas, la propia memoria debe convertirse en el ordenador.
 .class="img-fluid clearfix"
La física de la multiplicación de matrices con un solo transistor #
En la computación digital clásica, calcular un producto escalar de matrices exige traer miles de pesos de 8 o 16 bits desde una DRAM externa por líneas de bus de alta capacitancia, cargarlos en registros de caché, efectuar la multiplicación en ALU digitales y volver a escribir los resultados en memoria. Más del 90 % de la energía se gasta en cargar y descargar las interconexiones de cobre entre chips.
Las arquitecturas de cómputo en memoria sustituyen esta transferencia digital de datos por la física de los circuitos analógicos:
Programación de los pesos. Los pesos de la red neuronal se programan directamente en celdas de memoria no volátil (como flash modificada o RAM resistiva) en forma de conductancias analógicas ($G$). Una vez programados, los pesos permanecen fijos dentro de la matriz de memoria; nunca se leen ni se transfieren durante la inferencia.
Modulación de la tensión de entrada. Las activaciones de entrada (como los tokens visuales procedentes de las cámaras) se convierten en niveles de tensión analógicos ($V$) y se aplican a las líneas de palabra de la matriz.
Multiplicación por la ley de Ohm. Cuando la tensión de entrada atraviesa cada celda de memoria, la ley de Ohm ($I = V \times G$) efectúa una multiplicación analógica instantánea y genera una corriente proporcional al producto de la entrada por el peso almacenado.
Acumulación por la ley de corrientes de Kirchhoff. A lo largo de las líneas de bit verticales, las corrientes de miles de celdas en paralelo se suman de forma natural según la ley de corrientes de Kirchhoff ($\sum I = 0$).
Así, una sola matriz de memoria flash ejecuta una multiplicación matriz-vector completa en un único ciclo de reloj, a nivel físico y sin un solo acceso a memoria. La corriente analógica acumulada se vuelve a convertir en valores digitales mediante convertidores analógico-digitales (ADC) de alta velocidad situados en el borde de la matriz.
La estrategia de chiplets modulares #
Aunque el cómputo analógico en memoria resuelve las ecuaciones de energía y latencia, llevar el silicio a sectores comerciales muy diversos exige flexibilidad de encapsulado. En lugar de fabricar grandes sistemas en chip (SoC) monolíticos, que sufren tasas de defectos exponenciales, rendimientos de oblea pobres y configuraciones de producto rígidas, Ozcelik expuso una estrategia de chiplets modulares.
En este paradigma, pequeñas teselas estandarizadas de cómputo en memoria se fabrican por separado y se unen sobre intercaladores mediante encapsulado avanzado:
- Interconexiones estandarizadas de alta velocidad entre chips: apoyándose en normas emergentes como Universal Chiplet Interconnect Express (UCIe), los chiplets se comunican mediante microprotuberancias con una alta densidad de ancho de banda y latencias del orden del picosegundo.
- Composición heterogénea: un diseñador de sistemas puede combinar dos chiplets en memoria con un procesador de control ARM de bajo coste para la carga útil de un dron ligero, o montar dieciséis chiplets junto con interfaces PCIe de alta velocidad para crear una tarjeta aceleradora de servidor para centros de datos en el borde.
- Compilación universal y reparto de cargas: una capa de compilación unificada recibe grafos estándar de aprendizaje profundo (ONNX, PyTorch) y reparte automáticamente las capas del modelo sobre la topología de chiplets disponible, optimizando el enrutamiento de datos para reducir al mínimo la comunicación entre chiplets.
Comparación arquitectónica: paradigmas de cómputo para la robótica en el borde #
| Vector arquitectónico | GPU digital estándar (NVIDIA Jetson / Orin) | NPU de borde dedicada (Google Coral / Hailo) | Chiplet de cómputo analógico en memoria (Mythic AI) |
|---|---|---|---|
| Mecanismo subyacente | Núcleos digitales SIMD/tensoriales que traen los pesos de LPDDR5/HBM | Matrices sistólicas digitales con caché de pesos en SRAM integrada | Matrices analógicas de un solo transistor que multiplican matrices in situ |
| Sobrecoste del movimiento de datos | Alto (carga continua de los buses DRAM/SRAM; más del 85 % de energía desperdiciada) | Moderado (limitado por la capacidad de la caché SRAM interna) | Ningún movimiento interno de datos; los pesos permanecen siempre en memoria |
| Envolvente de potencia de inferencia | De 30 W a más de 75 W (requiere ventilación activa y disipadores pesados) | De 5 W a 15 W (refrigeración pasiva o mínima) | De 10 W a 20 W (disipación térmica pasiva ultracompacta) |
| Eficiencia energética (TOPS/W) | De 2 a 5 TOPS/vatio (a nivel de sistema) | De 10 a 25 TOPS/vatio | De 50 a más de 200 TOPS/vatio (eficiencia teórica de 10x a 1000x) |
| Lista de materiales del componente (BOM) | De 500 £ a más de 2500 £ por módulo de cómputo | De 100 £ a 350 £ por placa aceleradora | Unas decenas de dólares por chiplet en volumen |
| Cuello de botella de memoria (Von Neumann) | Grave; limitado por el ancho de banda de memoria (GB/s a TB/s) | Moderado; limitado por la capacidad de la SRAM integrada (MB) | Inexistente; el ancho de banda de la matriz coincide con el de la matriz de memoria interna |
| Ámbito de despliegue objetivo | Vehículos autónomos de gama alta y robots de inspección industrial | Cámaras inteligentes y dispositivos IoT integrados ligeros | Robótica táctil de alta frecuencia, drones tácticos e IA para automoción |
Fuente: síntesis de los datos de la conversación y de las especificaciones de arquitectura de semiconductores presentadas en la cumbre Physical AI and Robotics de Economist Enterprise (Convene 200 Aldersgate, Londres, 13 de octubre de 2026).
Qué significa por sector #
La validación comercial del cómputo en memoria depende de que penetre en sectores donde las limitaciones de potencia y coste han impedido hasta ahora el despliegue de modelos fundacionales avanzados.
Defensa táctica y sistemas no tripulados #
En las aplicaciones de defensa en el borde, la eficiencia energética se traduce directamente en capacidad de supervivencia operativa y en duración de la misión. Los pequeños sistemas aéreos no tripulados (sUAS) y los vehículos terrestres tácticos están muy limitados por el peso de la batería. Equipar un dron de reconocimiento con una GPU convencional reduce su autonomía de vuelo entre un 30 % y un 50 % solo para alimentar la pila de percepción de IA.
La colaboración estratégica de Mythic AI con Lockheed Martin se centra en integrar el cómputo en memoria en sistemas tácticos en el borde, enjambres de drones autónomos y puestos de vigilancia remotos. Al reducir el consumo de cómputo de 50 W a menos de 10 W, los drones tácticos prolongan su tiempo de vuelo mientras ejecutan localmente la clasificación multimodal de objetos, el procesamiento de señales de guerra electrónica y la odometría visual-inercial en teatros de operaciones disputados y sin GPS.
Percepción del entorno e IA de habitáculo en automoción #
En el sector del automóvil, los proveedores de primer nivel sufren una fuerte presión sobre los márgenes. Mientras que los vehículos eléctricos de gama alta pueden absorber el coste de ordenadores de conducción autónoma refrigerados por líquido de 2000 £, los vehículos de gran consumo no pueden.
La alianza de Honda Motor con Mythic AI responde a esta fricción comercial. Los fabricantes necesitan chips de IA cualificados para automoción, en gran volumen y que cuesten decenas de dólares en lugar de cientos, capaces de ejecutar la vigilancia del conductor, la segmentación de objetos en el ángulo muerto y la percepción envolvente de 360 grados sin complejos circuitos de refrigeración líquida que encarecen la fabricación y complican el montaje.
Centros de datos industriales en el borde y logística móvil #
Aunque el cómputo en memoria está optimizado para el borde, Mythic aplica una estrategia de puente deliberada al ofrecer tarjetas aceleradoras PCIe para centros de datos en el borde y centros logísticos. En instalaciones con cientos de robots móviles autónomos (AMR), los bastidores de servidores que ejecutan los modelos de coordinación de flotas están limitados por las acometidas eléctricas y la capacidad de refrigeración del recinto. Las tarjetas aceleradoras en memoria permiten multiplicar el rendimiento de inferencia local sin ampliar la infraestructura eléctrica.
Resiliencia de la cadena de suministro y geografía de fabricación #
Una parte fundamental de la intervención de Ozcelik giró en torno a la soberanía de la cadena de suministro. La innovación en hardware no sirve de nada si el silicio no puede fabricarse, encapsularse y enviarse de forma fiable y a escala.
Mythic AI ha establecido una huella de fabricación internacional distribuida:
- Fabricación del silicio: la producción de obleas de cómputo en memoria se concentra en Tokio, Japón, aprovechando el liderazgo consolidado de Japón en la fabricación de semiconductores de precisión y sus nodos de proceso analógicos y flash maduros.
- Encapsulado avanzado y montaje: las obleas se envían a Europa (concretamente a Alemania) para el corte avanzado de chiplets, la unión a sustratos multichip y la inspección óptica automatizada.
- Validación de la revisión: la empresa está terminando la validación de su última revisión de silicio, con el objetivo de convertir las métricas de rendimiento de laboratorio en pliegos de trabajo (SOW) repetibles y de calidad de producción para volúmenes de automoción y defensa.
Este enfoque multirregional evita vulnerabilidades geopolíticas de punto único y ofrece a los socios corporativos europeos y asiáticos cadenas de suministro geográficamente diversificadas.
Conclusión #
La conversación entre Taner Ozcelik y Kenneth Cukier en la cumbre Physical AI and Robotics de Economist Enterprise describió la realidad física que regirá la próxima década de sistemas autónomos. La ley de Moore, como simple medida del escalado de transistores, ya no basta para impulsar la revolución de la IA física.
Mientras las arquitecturas de cómputo sigan aferradas a la separación de Von Neumann entre lógica y memoria, la robótica seguirá limitada por la masa de las baterías, la disipación de calor y unos costes de lista de materiales prohibitivos. Al pasar del movimiento digital de datos a las matrices analógicas de cómputo en memoria y a las topologías de chiplets modulares, la ingeniería de semiconductores aporta el salto de eficiencia que necesitan los sistemas autónomos.
El paso de clústeres de centro de datos de 700 W a silicio de borde de 15 W es la verdadera puerta de entrada a la autonomía física. En último término, los robots que operan en el mundo real deben obedecer las leyes energéticas del mundo real; el cómputo en memoria es la arquitectura que tiende un puente entre el silicio y la biología.
Preguntas frecuentes #
¿Qué es el cuello de botella de Von Neumann en el hardware de IA? El cuello de botella de Von Neumann es el límite de rendimiento y de energía causado por la separación física entre la unidad de procesamiento (ALU) y la memoria del sistema (DRAM). En las cargas de inteligencia artificial, que implican miles de millones de multiplicaciones de matrices, los procesadores gastan más del 85 % de su energía total y muchos ciclos de reloj solo en mover datos de un lado a otro por buses de cobre, lo que crea graves cuellos de botella térmicos y de latencia.
¿Cómo funciona el cómputo analógico en memoria (CIM)? El cómputo en memoria realiza las operaciones matemáticas directamente dentro de las celdas de memoria, sin mover datos. Los pesos de la red neuronal se almacenan como estados de conductancia analógica en celdas de memoria no volátil. Al aplicar tensiones de entrada a la matriz, la corriente atraviesa las celdas según la ley de Ohm ($I = V \times G$) y se suma a lo largo de las líneas de bit según la ley de corrientes de Kirchhoff. Así se completa una multiplicación matriz-vector en un único paso físico.
¿Por qué el cómputo en memoria es especialmente crítico para los robots y los drones? Los robots móviles y los drones operan bajo estrictas limitaciones de tamaño, peso, potencia y coste (SWaP-C). Dependen de baterías a bordo y no pueden soportar radiadores pesados ni fuentes de alimentación de alta potencia. El cómputo en memoria ofrece una eficiencia energética entre 10 y 1000 veces mayor, lo que permite a los robots ejecutar localmente modelos complejos de visión-lenguaje-acción dentro de una envolvente de 10 W a 20 W sin sacrificar la autonomía de la batería.
¿Qué ventaja tiene el enfoque de chiplets frente a un chip monolítico? Los chips monolíticos integran todas las unidades funcionales en una única pastilla de silicio de gran tamaño. A medida que crece la pastilla, la tasa de defectos de fabricación aumenta de forma exponencial, lo que reduce el rendimiento de producción y eleva el coste unitario. Una arquitectura de chiplets divide el sistema en pastillas de silicio más pequeñas y estandarizadas, fabricadas por separado con alto rendimiento y conectadas mediante microprotuberancias de alta velocidad. Esto permite configuraciones modulares y flexibles, adaptadas a requisitos industriales concretos de potencia y formato.
¿Quiénes son los principales socios comerciales de esta tecnología? La plataforma de cómputo en memoria de Mythic AI se apoya hoy en dos grandes alianzas corporativas: Lockheed Martin, que integra la arquitectura en drones de defensa táctica, plataformas robóticas no tripuladas y puestos de seguridad perimetral para prolongar la autonomía de las baterías; y Honda Motor, que busca chips de IA de bajo coste y cualificados para automoción destinados a la percepción del entorno del vehículo y a la detección en el habitáculo.
Referencias #
- Economist Enterprise, (2026). Cumbre Physical AI & Robotics: ventaja operativa mediante sistemas autónomos ⧉. Economist Enterprise.
- Ozcelik, T., (2026). Más allá de la ley de Moore: la energía detrás de la robótica de alto rendimiento ⧉. Mythic AI.
- Cukier, K., (2026). Los techos termodinámicos de la inteligencia autónoma ⧉. The Economist.
- Marković, D., Mizrahi, A., Querlioz, D., y Grollier, J., (2020). Física para la computación neuromórfica ⧉. Nature Reviews Physics, 2, 499-510.
- Universal Chiplet Interconnect Express, (2025). Especificación UCIe 2.0: norma de interconexión entre chips ⧉. UCIe Consortium.
- IEEE, (2026). International Roadmap for Devices and Systems (IRDS): más allá de CMOS y del cómputo en memoria ⧉. IEEE Standards Association.
Última revisión .
Última revisión .
Republicar este artículo
Copiar formato para Medium
# Cómputo en memoria y chiplets: robótica más allá de la ley de Moore — Sebastien Rousseau

> Originally published at [https://sebastienrousseau.com/es/2026-10-13-computo-en-memoria-chiplets-robotica-mas/](https://sebastienrousseau.com/es/2026-10-13-computo-en-memoria-chiplets-robotica-mas/)

En la cumbre Physical AI and Robotics de Economist Enterprise, Taner Ozcelik (Mythic AI) mostró cómo el cómputo en memoria y los chiplets derriban el muro de la memoria.

Read the full article on sebastienrousseau.com: https://sebastienrousseau.com/es/2026-10-13-computo-en-memoria-chiplets-robotica-mas/
Copiar formato para Mastodon
Cómputo en memoria y chiplets: robótica más allá de la ley de Moore — Sebastien Rousseau

En la cumbre Physical AI and Robotics de Economist Enterprise, Taner Ozcelik (Mythic AI) mostró cómo el cómputo en memoria y los chiplets derriban el muro de la memoria.

https://sebastienrousseau.com/es/2026-10-13-computo-en-memoria-chiplets-robotica-mas/
Copiar formateado para LinkedIn
Cómputo en memoria y chiplets: robótica más allá de la ley de Moore — Sebastien Rousseau

En la cumbre Physical AI and Robotics de Economist Enterprise, Taner Ozcelik (Mythic AI) mostró cómo el cómputo en memoria y los chiplets derriban el muro de la memoria.

Estos son los puntos estratégicos clave:

- El muro termodinámico: por qué la IA física no puede vivir en la nube. En la sesión titulada Moving past Moore’s law: the power behind high-performance robotics, Kenneth Cukier planteó el dilema de ingeniería central de la autonomía empresarial: los modelos de inteligencia artificial…
- La tesis arquitectónica: el cómputo en memoria (CIM). Para resolver el cuello de botella termodinámico, Mythic AI defiende una filosofía arquitectónica: en lugar de trasladar datos entre unidades de procesamiento y reservas de memoria separadas, la propia memoria debe…
- La estrategia de chiplets modulares. Aunque el cómputo analógico en memoria resuelve las ecuaciones de energía y latencia, llevar el silicio a sectores comerciales muy diversos exige flexibilidad de encapsulado.
- Comparación arquitectónica: paradigmas de cómputo para la robótica en el borde. Fuente: síntesis de los datos de la conversación y de las especificaciones de arquitectura de semiconductores presentadas en la cumbre Physical AI and Robotics de Economist Enterprise (Convene 200 Aldersgate,…

¿Cuál es el enfoque de su organización ante los desafíos descritos en este artículo?

→ https://sebastienrousseau.com/es/2026-10-13-computo-en-memoria-chiplets-robotica-mas/

#CómputoEnMemoria #MythicAi #TanerOzcelik #LeyDeMoore #CuelloDeBotellaDeVonNeumann

Sebastien Rousseau | CC-BY-4.0
Citar este artículo
Cómputo en memoria y chiplets: robótica más allá de la ley de Moore — Sebastien Rousseau
En la cumbre Physical AI and Robotics de Economist Enterprise, Taner Ozcelik (Mythic AI) mostró cómo el cómputo en memoria y los chiplets derriban el muro de la memoria.
BibTeX
@online{rousseau2026cómputo,
  author  = {Rousseau, Sebastien},
  title   = {{Cómputo en memoria y chiplets: robótica más allá de la ley de Moore — Sebastien Rousseau}},
  year    = {2026},
  url     = {https://sebastienrousseau.com/es/2026-10-13-computo-en-memoria-chiplets-robotica-mas/},
  urldate = {2026}
}RIS
TY  - GEN
AU  - Rousseau, Sebastien
TI  - Cómputo en memoria y chiplets: robótica más allá de la ley de Moore — Sebastien Rousseau
PY  - 2026
UR  - https://sebastienrousseau.com/es/2026-10-13-computo-en-memoria-chiplets-robotica-mas/
ER  -
Vancouver
Rousseau S. Cómputo en memoria y chiplets: robótica más allá de la ley de Moore — Sebastien Rousseau. sebastienrousseau.com. 2026 Oct 13. Available from: https://sebastienrousseau.com/es/2026-10-13-computo-en-memoria-chiplets-robotica-mas/
Chicago
Rousseau, Sebastien. "Cómputo en memoria y chiplets: robótica más allá de la ley de Moore — Sebastien Rousseau." sebastienrousseau.com. October 13, 2026. https://sebastienrousseau.com/es/2026-10-13-computo-en-memoria-chiplets-robotica-mas/.
APA
Rousseau, S. (2026, October 13). Cómputo en memoria y chiplets: robótica más allá de la ley de Moore — Sebastien Rousseau. sebastienrousseau.com. https://sebastienrousseau.com/es/2026-10-13-computo-en-memoria-chiplets-robotica-mas/
Volver a publicar este artículo
Cómputo en memoria y chiplets: robótica más allá de la ley de Moore — Sebastien Rousseau
En la cumbre Physical AI and Robotics de Economist Enterprise, Taner Ozcelik (Mythic AI) mostró cómo el cómputo en memoria y los chiplets derriban el muro de la memoria.
Este artículo se publica bajo Creative Commons Attribution 4.0 International. La republicación requiere atribución a la URL canónica.
Cómputo en memoria y chiplets: robótica más allá de la ley de Moore — Sebastien Rousseau

En la cumbre Physical AI and Robotics de Economist Enterprise, Taner Ozcelik (Mythic AI) mostró cómo el cómputo en memoria y los chiplets derriban el muro de la memoria.

Originally published at https://sebastienrousseau.com/es/2026-10-13-computo-en-memoria-chiplets-robotica-mas/ by Sebastien Rousseau.
Licensed under CC-BY-4.0.