
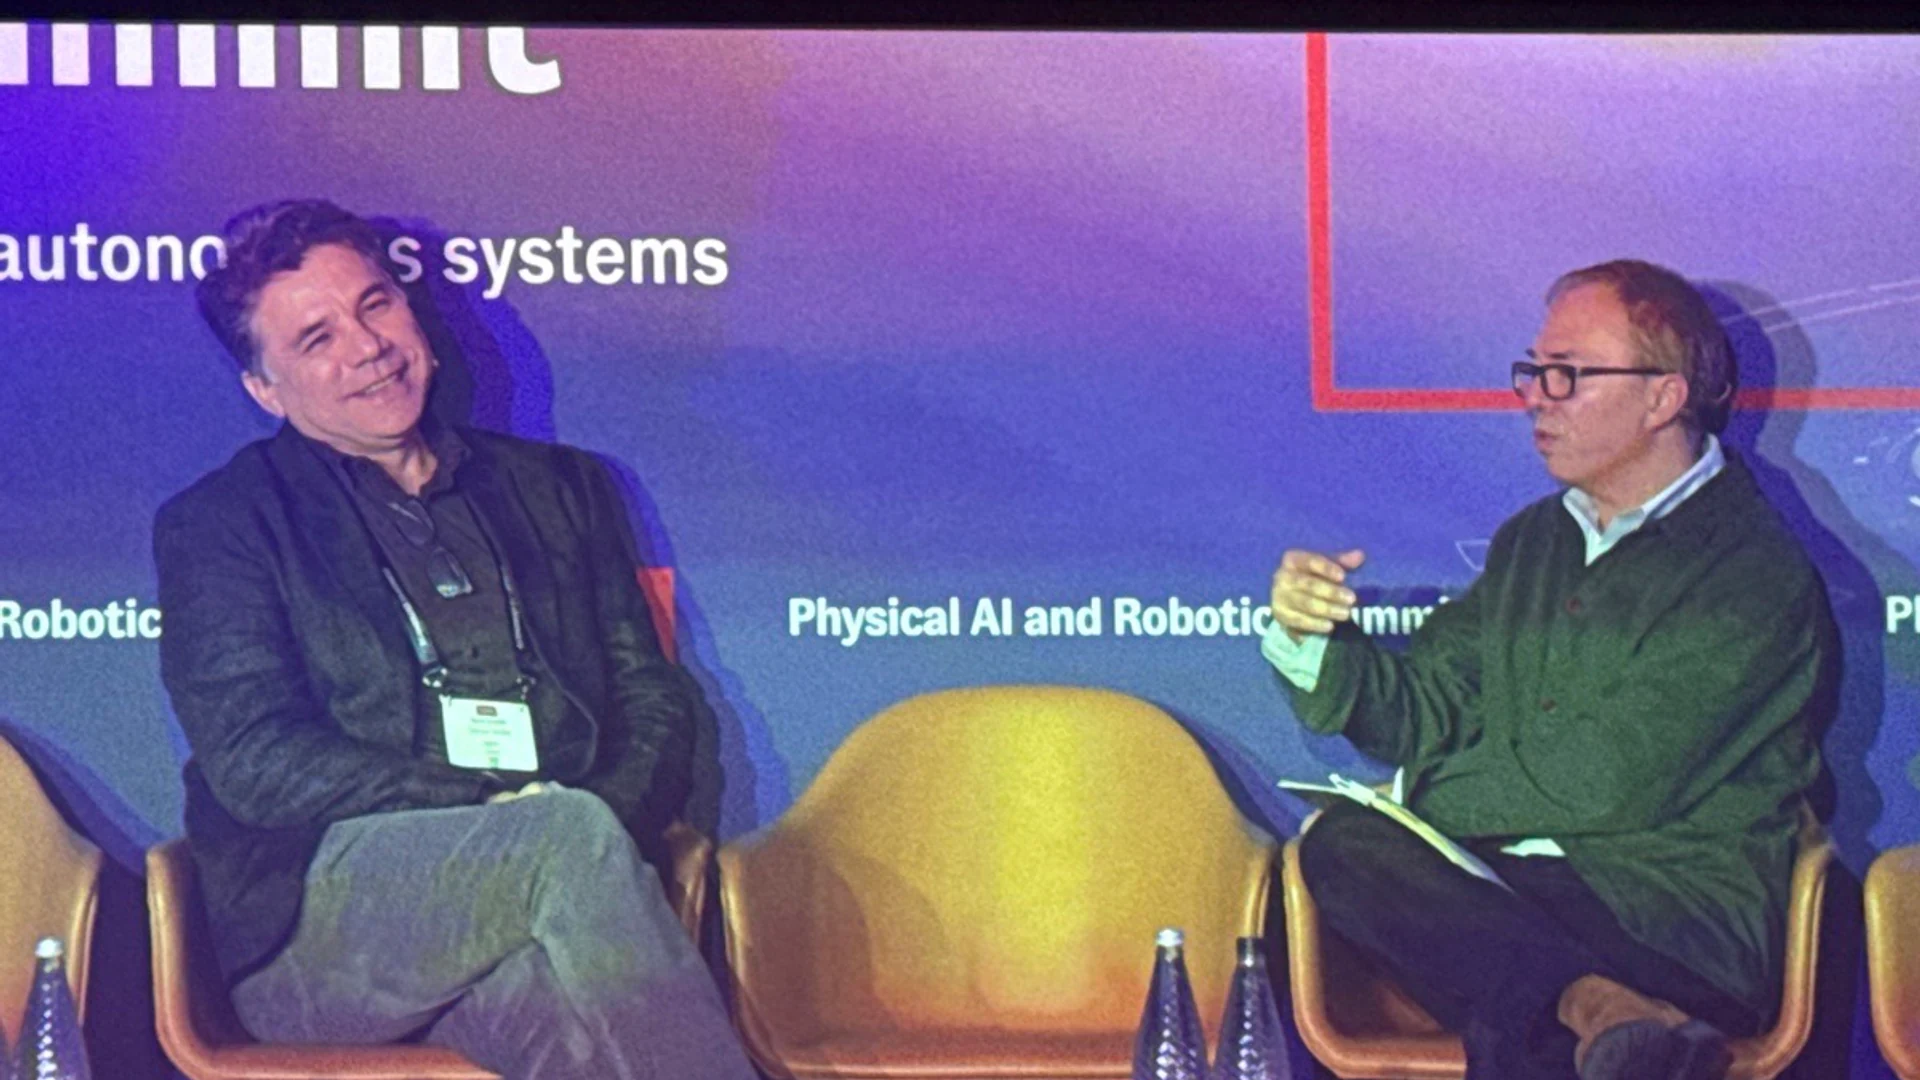
Sa loob ng mahigit kalahating siglo, sinunod ng pag-unlad ng computing ang batas ni Moore: ang pagsisiksik ng dobleng dami ng transistor sa silicon tuwing labingwalo hanggang dalawampu't apat na buwan. Ngunit sa umuusbong na larangan ng physical AI at autonomous robotics, bumangga na ang batas ni Moore sa mga batas ng thermodynamics. Hindi kayang buhatin ng mga autonomous drone, robotic quadruped, surgical manipulator at self-driving na sasakyan ang mga 700-watt na server-class GPU o mga cooling tower. Sa Economist Enterprise Physical AI and Robotics Summit sa London noong 13 Oktubre 2026, sumama si Taner Ozcelik, Chairman at Chief Executive ng Mythic AI, kay Kenneth Cukier sa isang fireside chat na sumuri sa rebolusyong pang-arkitektura na kailangan upang basagin ang pagkakatigil na ito: ang paglampas sa batas ni Moore sa pamamagitan ng analog compute-in-memory (CIM) at mga modular chiplet.
Ang thermodynamic wall: kung bakit hindi mabubuhay ang physical AI sa cloud #
Sa fireside session na pinamagatang Moving past Moore’s law: the power behind high-performance robotics, inilatag ni Kenneth Cukier ang pangunahing suliraning pang-inhinyeriya na kinakaharap ng enterprise autonomy: lumalaki ang mga artificial intelligence model sa laki ng parameter at sa kakayahang pandama, ngunit ang mga pisikal na makina ay gumagana sa ilalim ng mahigpit na SWaP-C constraint (Size, Weight, Power, and Cost).
Nakaangkla ang hangganan ng AI ngayon sa mga hyperscale data centre na kumokonsumo ng 150 megawatt o higit pa sa malalawak na server cluster. Gaya ng itinuro ni Ozcelik, gumagana ang arkitekturang ito sa mga sukat ng enerhiya na milyun-milyong ulit na malayo sa mga biyolohikal na sanggunian. Ang utak ng tao ay nagsasagawa ng tuloy-tuloy na real-time na sensorimotor coordination, semantic reasoning at visual-spatial navigation sa loob ng metabolic power envelope na humigit-kumulang 20 watt.
Sa kasaysayan, sinubukan ng mga robotics engineer na lampasan ang limitasyon ng on-board compute sa pamamagitan ng paglilipat ng inference sa cloud. Gayunman, sa mga mission-critical na kapaligirang pang-industriya, aerospace at depensa, imposible sa arkitektura ang autonomy na umaasa sa cloud:
- Pabagu-bagong latency at jitter: Ang high-speed closed-loop na kontrol ng robot ay nangangailangan ng deterministikong motor update sa 50Hz hanggang 1,000Hz (round-trip na mas mababa sa 20 millisecond). Ang mga cellular at Wi-Fi network ay nagdudulot ng packet jitter, nawawalang frame at biglang pagtaas ng latency na nagiging sanhi ng paglaglag ng mga robotic arm sa workpiece o ng pagkabigo ng mga autonomous na sasakyan na umabot sa braking threshold.
- Pagkapuno ng bandwidth: Ang pag-stream ng maraming hindi naka-compress na 4K video feed at LiDAR point cloud mula sa dose-dosenang mobile robot sa isang planta ay mabilis na umuubos sa lokal na RF bandwidth at nagdudulot ng napakataas na cloud egress fee.
- Operational sovereignty at pinagtatalunang koneksiyon: Sa underground mining, mga tunnel na walang GPS, malalayong construction site o mga taktikal na kapaligirang militar, ang mga panlabas na network link ay wala o aktibong jina-jam. Dapat dalhin ng mga autonomous system ang buong operational intelligence nang direkta sa edge chassis.
Ang paglalagay ng karaniwang high-performance GPU sa mga robot ay may sarili ring pisikal na kapalit: thermal throttling, malalaking heat sink na nagdaragdag ng parasitikong bigat sa payload, at mataas na konsumo ng kuryente na nagpapaikli sa flight time ng baterya mula oras tungo sa minuto.
Ang thesis ng arkitektura: Compute-In-Memory (CIM) #
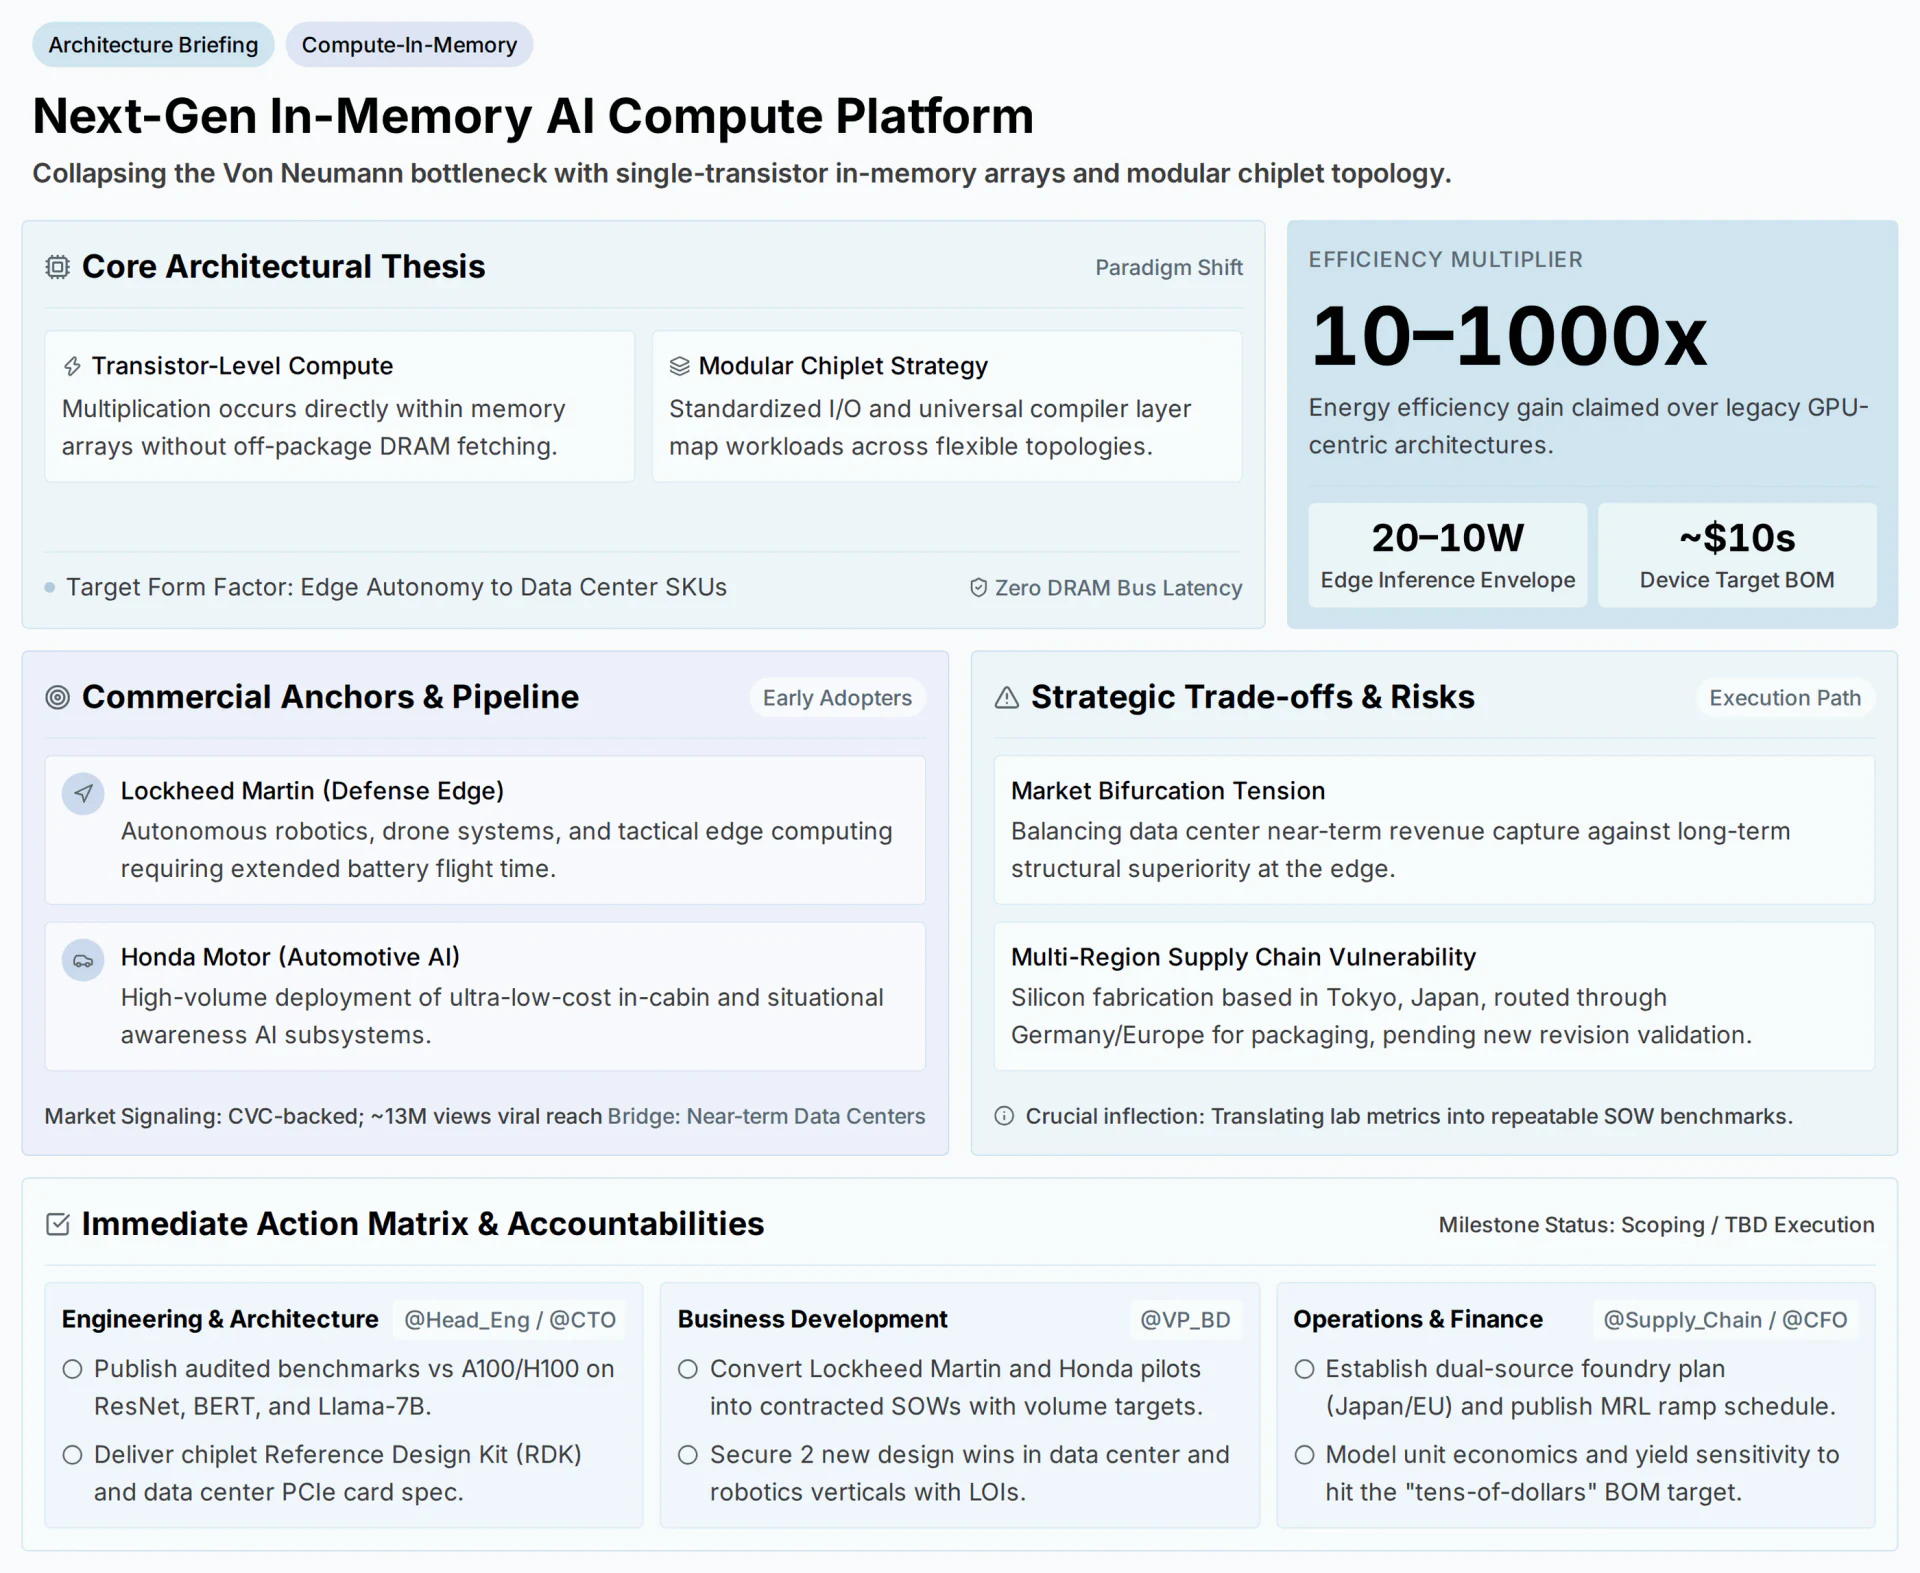
Upang lutasin ang thermodynamic bottleneck, isinulong ng Mythic AI ang isang pilosopiyang pang-arkitektura: sa halip na pabalik-balik na ilipat ang data sa pagitan ng magkahiwalay na processing unit at memory pool, ang memorya mismo ang dapat maging computer.
 .class="img-fluid clearfix"
Ang pisika ng matrix multiplication sa iisang transistor #
Sa klasikong digital computing, ang pagkalkula ng matrix dot product ay nangangailangan ng pagkuha ng libu-libong 8-bit o 16-bit na weight value mula sa panlabas na DRAM sa pamamagitan ng mga high-capacitance bus line, pagkarga ng mga ito sa cache register, pagsasagawa ng multiplication sa loob ng digital ALU, at pagsulat pabalik ng resulta sa memorya. Mahigit 90% ng enerhiya ang nagagamit sa pag-charge at pag-discharge ng mga copper interconnect line sa pagitan ng mga chip.
Pinapalitan ng mga in-memory compute architecture ang digital na paglilipat ng data na ito ng pisika ng analog circuit:
Pag-program ng weight. Direktang ipino-program ang mga neural network weight sa mga non-volatile memory cell (gaya ng binagong flash o resistive RAM) bilang mga analog conductance ($G$). Kapag na-program na, nananatiling nakapirmi ang mga weight sa loob ng memory array; hindi kailanman kinukuha o inililipat ang mga ito sa panahon ng inference.
Modulasyon ng input voltage. Ang mga input activation (gaya ng mga visual token mula sa camera) ay kino-convert sa mga analog voltage level ($V$) at pinadadaloy sa mga word line ng array.
Multiplication sa batas ni Ohm. Habang dumaraan ang input voltage sa bawat memory cell, isinasagawa ng batas ni Ohm ($I = V \times G$) ang agarang analog multiplication, na lumilikha ng kuryenteng proporsiyonal sa produkto ng input at ng nakaimbak na weight.
Akumulasyon sa Kirchhoff's Current Law. Sa mga patayong bit line, kusang nagsasama-sama ang mga kuryente mula sa libu-libong magkakaparalelong memory cell ayon sa Kirchhoff's Current Law ($\sum I = 0$).
Kaya isinasagawa ng iisang flash memory array ang buong matrix-vector multiplication sa iisang clock cycle, gumagana sa antas ng pisika nang walang kahit isang memory fetch. Pagkatapos, ang naipong analog current ay kino-convert pabalik sa digital value sa pamamagitan ng mga high-speed analog-to-digital converter (ADC) sa gilid ng array.
Ang modular na estratehiya ng chiplet #
Bagama't nalulutas ng analog compute-in-memory ang mga equation ng enerhiya at latency, ang pagpapalawak ng silicon sa iba't ibang komersiyal na larangan ay nangangailangan ng flexibility sa packaging. Sa halip na gumawa ng malalaki at monolitikong system-on-chip (SoC) - na dumaranas ng eksponensiyal na defect rate, mababang wafer yield at hindi nababagong configuration ng produkto - inilatag ni Ozcelik ang isang modular na estratehiya ng chiplet.
Sa paradigmang ito, ang maliliit at istandardisadong in-memory compute tile ay hiwalay na ginagawa at idinidikit sa mga interposer gamit ang advanced packaging:
- Istandardisadong high-speed die-to-die interconnect: Gamit ang mga umuusbong na pamantayan gaya ng Universal Chiplet Interconnect Express (UCIe), nag-uusap ang mga chiplet sa pamamagitan ng mga micro-bump na may mataas na bandwidth density at latency sa antas ng picosecond.
- Heterogeneous na komposisyon: Maaaring ipares ng isang system designer ang dalawang in-memory chiplet sa isang murang ARM control processor para sa magaang drone payload, o pagsamahin ang labing-anim na chiplet kasama ang high-speed PCIe interface upang makabuo ng server accelerator card para sa mga edge data centre.
- Unibersal na compilation at workload mapping: Isang pinag-isang compiler layer ang tumatanggap ng mga karaniwang deep learning graph (ONNX, PyTorch) at awtomatikong hinahati ang mga layer ng modelo sa magagamit na chiplet topology, na ino-optimize ang data routing upang mabawasan ang komunikasyon sa pagitan ng mga chiplet.
Paghahambing ng arkitektura: mga paradigma ng compute para sa edge robotics #
| Vector ng arkitektura | Karaniwang digital GPU (NVIDIA Jetson / Orin) | Nakalaang edge NPU (Google Coral / Hailo) | Analog Compute-In-Memory chiplet (Mythic AI) |
|---|---|---|---|
| Pinagbabatayang mekanismo | Digital SIMD/tensor core na kumukuha ng weight mula sa LPDDR5/HBM | Digital systolic array na may weight caching sa on-chip SRAM | Analog na array na tig-iisang transistor na nagsasagawa ng in-situ matrix multiply |
| Overhead ng paglilipat ng data | Mataas (tuloy-tuloy na pag-charge ng DRAM/SRAM bus; 85%+ na nasasayang na enerhiya) | Katamtaman (limitado ng kapasidad ng panloob na SRAM cache) | Walang panloob na paglilipat ng data; permanenteng nananatili ang weight sa memorya |
| Power envelope ng inference | 30W hanggang 75W+ (nangangailangan ng aktibong fan cooling at mabibigat na heat sink) | 5W hanggang 15W (passive o minimal na cooling) | 10W hanggang 20W (napakasiksik na passive thermal dissipation) |
| Kahusayan sa enerhiya (TOPS/W) | 2 hanggang 5 TOPS/Watt (sa antas ng sistema) | 10 hanggang 25 TOPS/Watt | 50 hanggang 200+ TOPS/Watt (10x-1000x na teoretikal na kahusayan) |
| Bill-of-materials (BOM) ng device | £500 hanggang £2,500+ bawat compute module | £100 hanggang £350 bawat accelerator board | Sampu-sampung dolyar bawat chiplet unit sa malakihang produksiyon |
| Memory bottleneck (Von Neumann) | Malubha; limitado ng memory bandwidth (GB/s hanggang TB/s) | Katamtaman; limitado ng kapasidad ng on-chip SRAM (MBs) | Wala; tugma ang bandwidth ng array sa panloob na memory matrix |
| Target na larangan ng deployment | Mga premium na autonomous na sasakyan at industrial inspection robot | Mga smart camera at magaang embedded IoT device | High-rate tactile robotics, tactical drone at automotive AI |
Pinagmulan: Sintesis ng datos mula sa fireside discussion at ng mga espesipikasyon ng semiconductor architecture na iniharap sa Economist Enterprise Physical AI and Robotics Summit (Convene 200 Aldersgate, London, 13 Oktubre 2026).
Ang kahulugan nito sa bawat sektor #
Nakasalalay ang komersiyal na pagpapatunay ng in-memory compute sa pagpasok sa mga industriyang dati'y hinarangan ng mga limitasyon sa kuryente at gastos sa paggamit ng mga advanced foundation model.
Tactical defence at mga unmanned system #
Sa mga edge application ng depensa, direktang nagiging operational survivability at haba ng misyon ang kahusayan sa enerhiya. Ang maliliit na unmanned aerial system (sUAS) at mga tactical ground rover ay mahigpit na limitado ng bigat ng baterya. Ang paglalagay ng karaniwang GPU sa isang reconnaissance drone ay nagbabawas ng tagal nito sa himpapawid nang 30% hanggang 50% para lang mapagana ang AI perception stack.
Nakatuon ang estratehikong ugnayan ng Mythic AI sa Lockheed Martin sa paglalagay ng in-memory compute sa mga tactical edge system, autonomous drone swarm at malalayong surveillance post. Sa pagbaba ng konsumo ng compute mula 50W tungo sa mas mababa sa 10W, nakakamit ng mga tactical drone ang mas mahabang flight time habang lokal na nagpapatakbo ng multi-modal object classification, electronic warfare signal processing at visual-inertial odometry sa mga pinagtatalunan at walang-GPS na operational theatre.
Automotive situational awareness at in-cabin AI #
Sa sektor ng automotive, nahaharap ang mga tier-one manufacturer sa matinding pagkipot ng margin. Bagama't kayang pasanin ng mga flagship electric vehicle ang gastos ng £2,000 na liquid-cooled autonomous driving computer, hindi ito kaya ng mga sasakyang pangmasa.
Tinutugunan ng pakikipagsosyo ng Honda Motor sa Mythic AI ang komersiyal na sagabal na ito. Kailangan ng mga automaker ng malakihang produksiyon ng automotive-qualified AI chip na nagkakahalaga ng sampu-sampung dolyar sa halip na daan-daan, na kayang magpatakbo ng driver-monitoring system, blind-spot object segmentation at 360-degree surround perception nang hindi nangangailangan ng masalimuot na liquid cooling loop na nagdaragdag ng gastos sa paggawa at ng komplikasyon sa assembly.
Mga industrial edge data centre at mobile fulfillment #
Bagama't in-optimize ang in-memory compute para sa edge, sinasadyang nagpapatupad ang Mythic ng isang bridge strategy sa pag-aalok ng mga PCIe accelerator card para sa mga edge data centre at warehouse fulfillment hub. Sa mga pasilidad na may daan-daang autonomous mobile robot (AMR), limitado ng electrical drop at cooling limit ng pasilidad ang mga edge server rack na nagpapatakbo ng mga fleet coordination model. Pinapayagan ng mga in-memory accelerator card ang mga pasilidad na paramihin ang lokal na inference throughput nang hindi ina-upgrade ang imprastraktura ng kuryente.
Katatagan ng supply chain at heograpiya ng paggawa #
Isang mahalagang bahagi ng briefing ni Ozcelik ang soberanya ng supply chain. Walang saysay ang inobasyon sa hardware kung hindi maaasahang magagawa, mapa-package at maipadala ang silicon sa malaking sukat.
Nagtatag ang Mythic AI ng isang distributed na pandaigdigang footprint sa paggawa:
- Silicon fabrication: Nakaangkla sa Tokyo, Japan ang pangunahing produksiyon ng in-memory wafer, na sinasamantala ang matatag na pamumuno ng Japan sa precision semiconductor fabrication at sa mga mature na analog/flash process node.
- Advanced packaging at assembly: Ipinapadala ang mga wafer sa Europe (partikular sa Germany) para sa advanced chiplet dicing, multi-die substrate bonding at automated optical inspection.
- Validation ng rebisyon: Kasalukuyang tinatapos ng kumpanya ang validation ng pinakabagong rebisyon ng silicon nito, na nakatuon sa pagsasalin ng mga laboratory yield metric tungo sa mauulit at production-grade na Statements of Work (SOW) para sa malakihang produksiyon sa automotive at depensa.
Iniiwasan ng multi-region na diskarteng ito ang mga geopolitical na kahinaan na nakasalalay sa iisang punto, habang nagbibigay sa mga corporate partner sa Europe at Asia ng mga supply chain na iba-iba ang heograpiya.
Konklusyon #
Inilatag ng fireside dialogue nina Taner Ozcelik at Kenneth Cukier sa Economist Enterprise Physical AI and Robotics Summit ang pisikal na realidad na mamamahala sa susunod na dekada ng mga autonomous system. Ang batas ni Moore, bilang simpleng sukatan ng transistor scaling, ay hindi na sapat upang paandarin ang rebolusyon ng physical AI.
Hangga't kumakapit ang mga computing architecture sa paghihiwalay ng logic at memorya ayon kay Von Neumann, mananatiling limitado ang robotics ng bigat ng baterya, ng heat dissipation at ng napakataas na gastos sa bill-of-materials. Sa paglipat mula sa digital na paglilipat ng data tungo sa mga analog in-memory compute array at modular chiplet topology, naghahatid ang semiconductor engineering ng biglang paglukso sa kahusayan na kailangan ng mga autonomous system.
Ang paglipat mula sa 700W na data-centre cluster tungo sa 15W na edge silicon ang tunay na pintuan patungo sa pisikal na awtonomiya. Sa huling pagsusuri, ang mga robot na gumagana sa totoong mundo ay dapat sumunod sa mga batas ng enerhiya ng totoong mundo; ang in-memory compute ang arkitekturang tumutulay sa pagitan ng silicon at biyolohiya.
Mga Madalas Itanong #
Ano ang Von Neumann bottleneck sa AI hardware? Ang Von Neumann bottleneck ay ang limitasyon sa throughput at enerhiya na dulot ng pisikal na paghihiwalay ng central processing unit (ALU) at ng system memory (DRAM). Sa mga artificial intelligence workload, na may bilyun-bilyong matrix multiplication, ginugugol ng mga processor ang mahigit 85% ng kanilang kabuuang enerhiya at malaking bahagi ng clock cycle sa pabalik-balik na paglilipat lamang ng data sa mga copper bus, na lumilikha ng malubhang thermal at latency bottleneck.
Paano gumagana ang analog Compute-In-Memory (CIM)? Isinasagawa ng Compute-In-Memory ang mga operasyong pangmatematika nang direkta sa loob ng mga memory cell nang hindi inililipat ang data. Iniimbak ang mga neural network weight bilang mga analog conductance state sa loob ng mga non-volatile memory cell. Kapag inilapat ang mga input voltage sa array, dumadaloy ang kuryente sa mga cell ayon sa batas ni Ohm ($I = V \times G$) at nagsasama-sama sa mga bit line ayon sa Kirchhoff's Current Law. Nagagawa nito ang buong matrix-vector multiplication sa iisang pisikal na hakbang.
Bakit lalong mahalaga ang in-memory compute para sa robotics at drone? Gumagana ang mga mobile robot at drone sa ilalim ng mahigpit na limitasyon sa Size, Weight, Power, and Cost (SWaP-C). Umaasa sila sa on-board na baterya at hindi kayang suportahan ang mabibigat na cooling radiator o ang mga power supply na mataas ang wattage. Nagbibigay ang in-memory compute ng 10x hanggang 1,000x na mas mataas na kahusayan sa enerhiya, kaya napapatakbo ng mga robot nang lokal ang masalimuot na vision-language-action model sa loob ng 10W hanggang 20W na power envelope habang pinapanatili ang tagal ng baterya.
Ano ang kalamangan ng chiplet approach kumpara sa monolitikong chip? Pinagsasama ng mga monolitikong chip ang lahat ng functional unit sa iisang malaking silicon die. Habang lumalaki ang die, eksponensiyal na tumataas ang defect rate sa paggawa, kaya bumababa ang production yield at tumataas ang gastos bawat unit. Hinahati ng chiplet architecture ang sistema sa mas maliliit at istandardisadong silicon die na hiwalay na ginagawa nang may mataas na yield at pinagdudugtong sa pamamagitan ng mga high-speed micro-bump. Pinapayagan nito ang modular at flexible na configuration na iniangkop sa partikular na pangangailangan sa kuryente at form factor ng industriya.
Sino ang mga pangunahing komersiyal na partner ng teknolohiyang ito? Kasalukuyang nakaangkla ang in-memory compute platform ng Mythic AI sa dalawang malaking corporate partnership: ang Lockheed Martin, na isinasama ang arkitektura sa mga tactical defence drone, unmanned robotic platform at perimeter security post upang pahabain ang tagal ng baterya; at ang Honda Motor, na tinutudla ang mura at automotive-qualified na AI chip para sa situational awareness ng sasakyan at in-cabin sensing.
Mga Sanggunian #
- Economist Enterprise, (2026). Physical AI & Robotics Summit: Kalamangang pang-operasyon sa pamamagitan ng mga autonomous system ⧉. Economist Enterprise.
- Ozcelik, T., (2026). Paglampas sa batas ni Moore: ang lakas sa likod ng high-performance robotics ⧉. Mythic AI.
- Cukier, K., (2026). Ang mga thermodynamic na hangganan ng autonomous intelligence ⧉. The Economist.
- Marković, D., Mizrahi, A., Querlioz, D., & Grollier, J., (2020). Pisika para sa neuromorphic computing ⧉. Nature Reviews Physics, 2, 499-510.
- Universal Chiplet Interconnect Express, (2025). UCIe Specification 2.0: Pamantayan ng die-to-die interconnect ⧉. UCIe Consortium.
- IEEE, (2026). International Roadmap for Devices and Systems (IRDS): Lampas sa CMOS at Compute-in-Memory ⧉. IEEE Standards Association.
Huling sinuri .
Huling sinuri .
I-cross-post ang artikulong ito
Kopyahin ang format para sa Medium
# Lampas sa batas ni Moore: in-memory compute at chiplets sa robotics — Sebastien Rousseau

> Originally published at [https://sebastienrousseau.com/fil/2026-10-13-lampas-sa-batas-ni-moore/](https://sebastienrousseau.com/fil/2026-10-13-lampas-sa-batas-ni-moore/)

Sa Economist Enterprise Physical AI and Robotics Summit sa London, ipinaliwanag ni Taner Ozcelik ng Mythic AI kung paano binabasag ng in-memory compute ang memory wall.

Read the full article on sebastienrousseau.com: https://sebastienrousseau.com/fil/2026-10-13-lampas-sa-batas-ni-moore/
Kopyahin ang format para sa Mastodon
Lampas sa batas ni Moore: in-memory compute at chiplets sa robotics — Sebastien Rousseau

Sa Economist Enterprise Physical AI and Robotics Summit sa London, ipinaliwanag ni Taner Ozcelik ng Mythic AI kung paano binabasag ng in-memory compute ang memory wall.

https://sebastienrousseau.com/fil/2026-10-13-lampas-sa-batas-ni-moore/
Kopyahin na naka-format para sa LinkedIn
Lampas sa batas ni Moore: in-memory compute at chiplets sa robotics — Sebastien Rousseau

Sa Economist Enterprise Physical AI and Robotics Summit sa London, ipinaliwanag ni Taner Ozcelik ng Mythic AI kung paano binabasag ng in-memory compute ang memory wall.

Narito ang mga pangunahing estratehikong aral:

- Ang thermodynamic wall: kung bakit hindi mabubuhay ang physical AI sa cloud. Sa fireside session na pinamagatang Moving past Moore’s law: the power behind high-performance robotics, inilatag ni Kenneth Cukier ang pangunahing suliraning pang-inhinyeriya na kinakaharap ng enterprise autonomy:…
- Ang thesis ng arkitektura: Compute-In-Memory (CIM). Upang lutasin ang thermodynamic bottleneck, isinulong ng Mythic AI ang isang pilosopiyang pang-arkitektura: sa halip na pabalik-balik na ilipat ang data sa pagitan ng magkahiwalay na processing unit at memory pool,…
- Ang modular na estratehiya ng chiplet. Bagama't nalulutas ng analog compute-in-memory ang mga equation ng enerhiya at latency, ang pagpapalawak ng silicon sa iba't ibang komersiyal na larangan ay nangangailangan ng flexibility sa packaging.
- Paghahambing ng arkitektura: mga paradigma ng compute para sa edge robotics. Pinagmulan: Sintesis ng datos mula sa fireside discussion at ng mga espesipikasyon ng semiconductor architecture na iniharap sa Economist Enterprise Physical AI and Robotics Summit (Convene 200 Aldersgate, London, 13…

Ano ang diskarte ng inyong organisasyon sa mga hamon na tinukoy sa piraso na ito?

→ https://sebastienrousseau.com/fil/2026-10-13-lampas-sa-batas-ni-moore/

#InMemoryCompute #MythicAi #TanerOzcelik #BatasNiMoore #VonNeumannBottleneck

Sebastien Rousseau | CC-BY-4.0
Sipiin ang artikulong ito
Lampas sa batas ni Moore: in-memory compute at chiplets sa robotics — Sebastien Rousseau
Sa Economist Enterprise Physical AI and Robotics Summit sa London, ipinaliwanag ni Taner Ozcelik ng Mythic AI kung paano binabasag ng in-memory compute ang memory wall.
BibTeX
@online{rousseau2026lampas,
  author  = {Rousseau, Sebastien},
  title   = {{Lampas sa batas ni Moore: in-memory compute at chiplets sa robotics — Sebastien Rousseau}},
  year    = {2026},
  url     = {https://sebastienrousseau.com/fil/2026-10-13-lampas-sa-batas-ni-moore/},
  urldate = {2026}
}RIS
TY  - GEN
AU  - Rousseau, Sebastien
TI  - Lampas sa batas ni Moore: in-memory compute at chiplets sa robotics — Sebastien Rousseau
PY  - 2026
UR  - https://sebastienrousseau.com/fil/2026-10-13-lampas-sa-batas-ni-moore/
ER  -
Vancouver
Rousseau S. Lampas sa batas ni Moore: in-memory compute at chiplets sa robotics — Sebastien Rousseau. sebastienrousseau.com. 2026 Oct 13. Available from: https://sebastienrousseau.com/fil/2026-10-13-lampas-sa-batas-ni-moore/
Chicago
Rousseau, Sebastien. "Lampas sa batas ni Moore: in-memory compute at chiplets sa robotics — Sebastien Rousseau." sebastienrousseau.com. October 13, 2026. https://sebastienrousseau.com/fil/2026-10-13-lampas-sa-batas-ni-moore/.
APA
Rousseau, S. (2026, October 13). Lampas sa batas ni Moore: in-memory compute at chiplets sa robotics — Sebastien Rousseau. sebastienrousseau.com. https://sebastienrousseau.com/fil/2026-10-13-lampas-sa-batas-ni-moore/
Muling i-publish ang artikulong ito
Lampas sa batas ni Moore: in-memory compute at chiplets sa robotics — Sebastien Rousseau
Sa Economist Enterprise Physical AI and Robotics Summit sa London, ipinaliwanag ni Taner Ozcelik ng Mythic AI kung paano binabasag ng in-memory compute ang memory wall.
Ang artikulong ito ay nakapailalim sa lisensya ng Creative Commons Attribution 4.0 International. Kailangan ng pagkilala sa canonical URL para sa muling pag-publish.
Lampas sa batas ni Moore: in-memory compute at chiplets sa robotics — Sebastien Rousseau

Sa Economist Enterprise Physical AI and Robotics Summit sa London, ipinaliwanag ni Taner Ozcelik ng Mythic AI kung paano binabasag ng in-memory compute ang memory wall.

Originally published at https://sebastienrousseau.com/fil/2026-10-13-lampas-sa-batas-ni-moore/ by Sebastien Rousseau.
Licensed under CC-BY-4.0.