
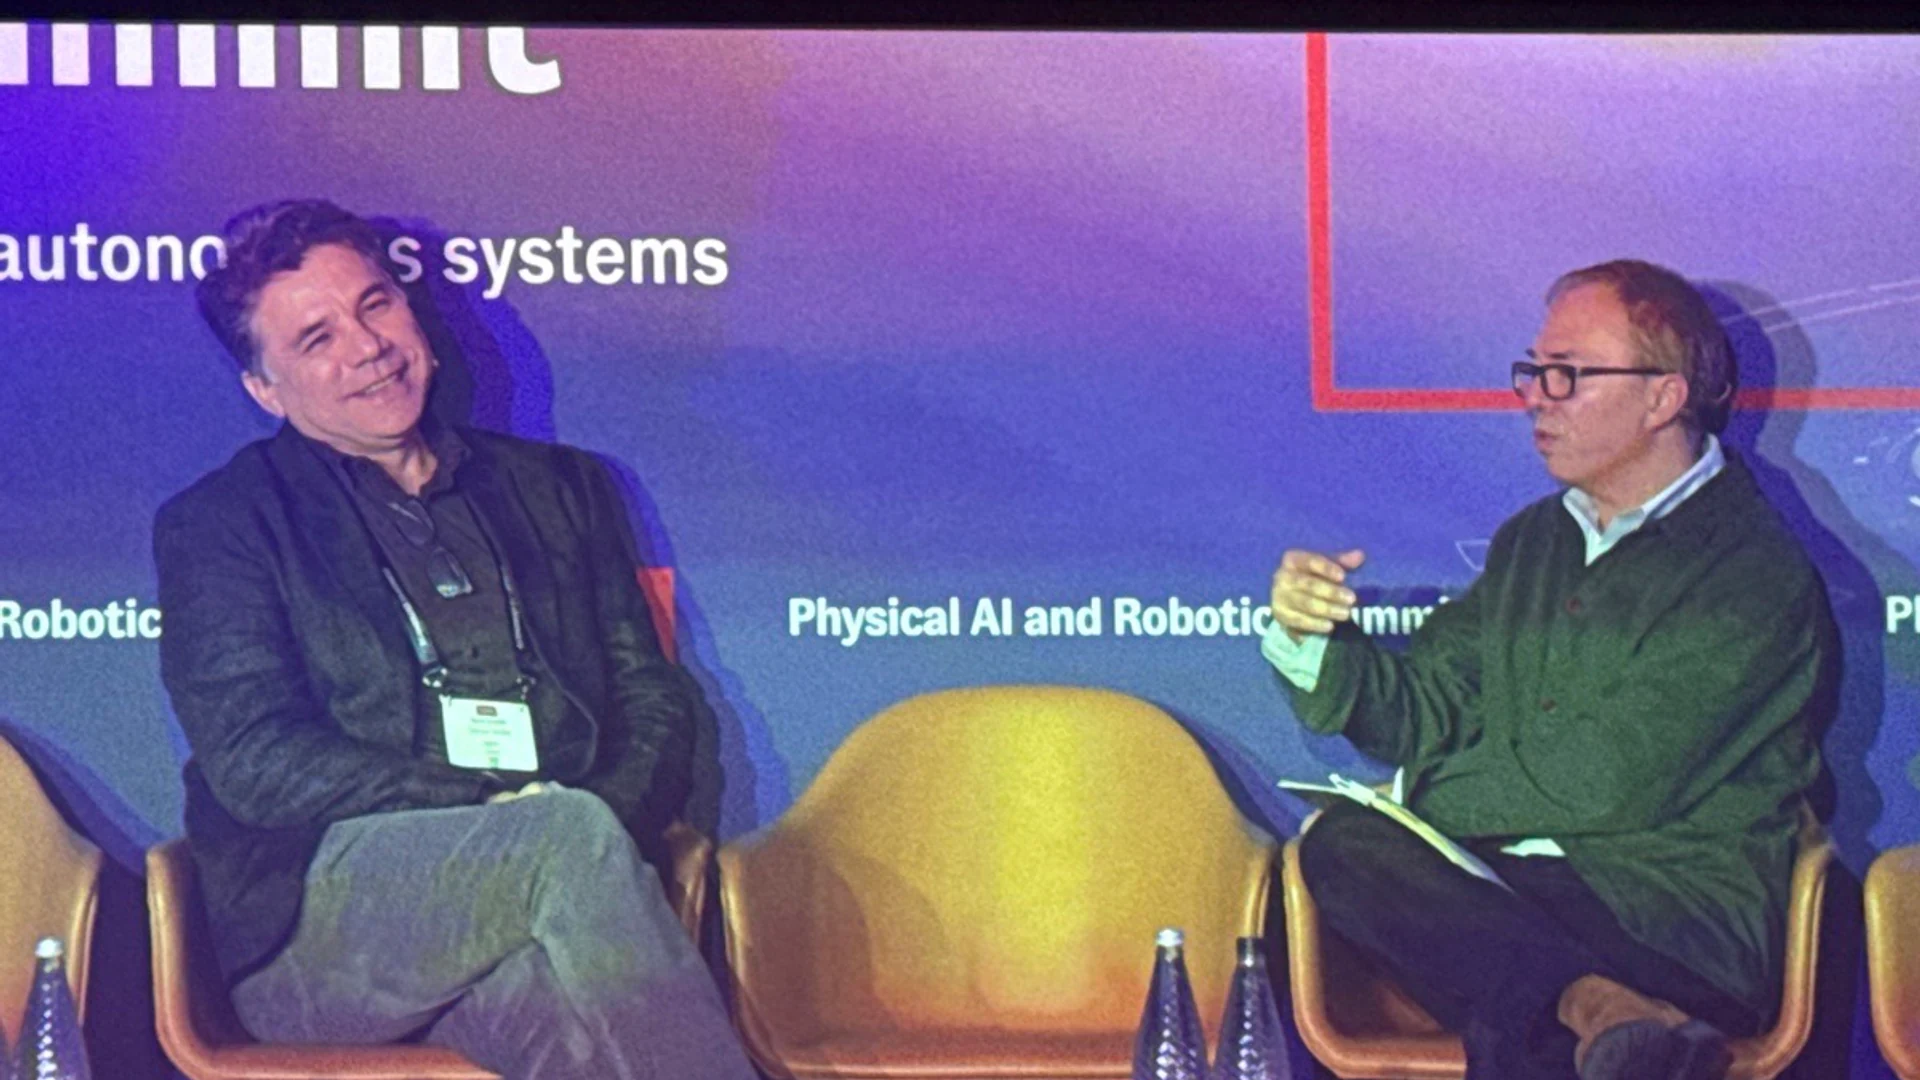
Przez ponad pół wieku postęp w informatyce podlegał prawu Moore’a: co osiemnaście do dwudziestu czterech miesięcy na krzemie mieściło się dwa razy więcej tranzystorów. Jednak w rodzącej się dziedzinie fizycznej AI i autonomicznej robotyki prawo Moore’a zderzyło się z prawami termodynamiki. Autonomiczne drony, czworonożne roboty, manipulatory chirurgiczne i pojazdy autonomiczne nie uniosą serwerowych procesorów GPU o mocy 700 watów ani wież chłodniczych. Na Economist Enterprise Physical AI and Robotics Summit w Londynie 13 października 2026 r. Taner Ozcelik, przewodniczący i prezes Mythic AI, rozmawiał z Kennethem Cukierem o architektonicznej rewolucji potrzebnej do wyjścia z tego impasu: o wyjściu poza prawo Moore’a dzięki analogowym obliczeniom w pamięci (compute-in-memory, CIM) i modułowym chipletom.
Ściana termodynamiczna: dlaczego fizyczna AI nie może żyć w chmurze #
Podczas rozmowy zatytułowanej Moving past Moore’s law: the power behind high-performance robotics (Poza prawem Moore’a: moc stojąca za wydajną robotyką) Kenneth Cukier nakreślił zasadniczy dylemat inżynieryjny autonomii w przedsiębiorstwach: modele sztucznej inteligencji rosną pod względem liczby parametrów i zdolności percepcyjnych, ale maszyny fizyczne działają pod bezlitosnymi ograniczeniami SWaP-C (rozmiar, waga, moc i koszt).
Dzisiejsza czołówka AI opiera się na hiperskalowych centrach danych pobierających 150 megawatów lub więcej w ogromnych klastrach serwerów. Jak zauważył Ozcelik, ta architektura działa w skali energii miliony razy odległej od biologicznych punktów odniesienia. Ludzki mózg prowadzi ciągłą koordynację czuciowo-ruchową w czasie rzeczywistym, wnioskowanie semantyczne i nawigację wzrokowo-przestrzenną w metabolicznym budżecie mocy wynoszącym około 20 watów.
W przeszłości inżynierowie robotyki próbowali obejść ograniczenia mocy obliczeniowej na pokładzie, przenosząc wnioskowanie do chmury. W krytycznych zastosowaniach przemysłowych, lotniczych i obronnych autonomia zależna od chmury jest jednak architektoniczną niemożliwością:
- Zmienność opóźnień i jitter: Szybkie sterowanie robotami w pętli zamkniętej wymaga deterministycznych aktualizacji silników z częstotliwością od 50 do 1000 Hz (pełny obieg poniżej 20 milisekund). Sieci komórkowe i Wi-Fi wprowadzają jitter pakietów, gubienie ramek i skoki opóźnień, przez które ramiona robotów upuszczają obrabiane elementy, a pojazdy autonomiczne nie dotrzymują progów hamowania.
- Nasycenie przepustowości: Przesyłanie wielu nieskompresowanych strumieni wideo 4K i chmur punktów LiDAR z dziesiątek robotów mobilnych w zakładzie przemysłowym szybko wyczerpuje lokalne pasmo radiowe i generuje wygórowane opłaty za transfer danych z chmury.
- Suwerenność operacyjna i zakłócana łączność: W kopalniach podziemnych, tunelach bez GPS, odległych placach budowy czy taktycznych środowiskach wojskowych zewnętrzne łącza sieciowe albo nie istnieją, albo są aktywnie zagłuszane. Systemy autonomiczne muszą nosić całą inteligencję operacyjną bezpośrednio na swoim brzegowym podwoziu.
Wyposażenie robotów w standardowe wydajne procesory GPU niesie własne fizyczne koszty: dławienie termiczne, ogromne radiatory, które dodają pasożytniczą masę ładunku, oraz duży pobór mocy, który skraca czas lotu na baterii z godzin do minut.
Teza architektoniczna: obliczenia w pamięci (CIM) #
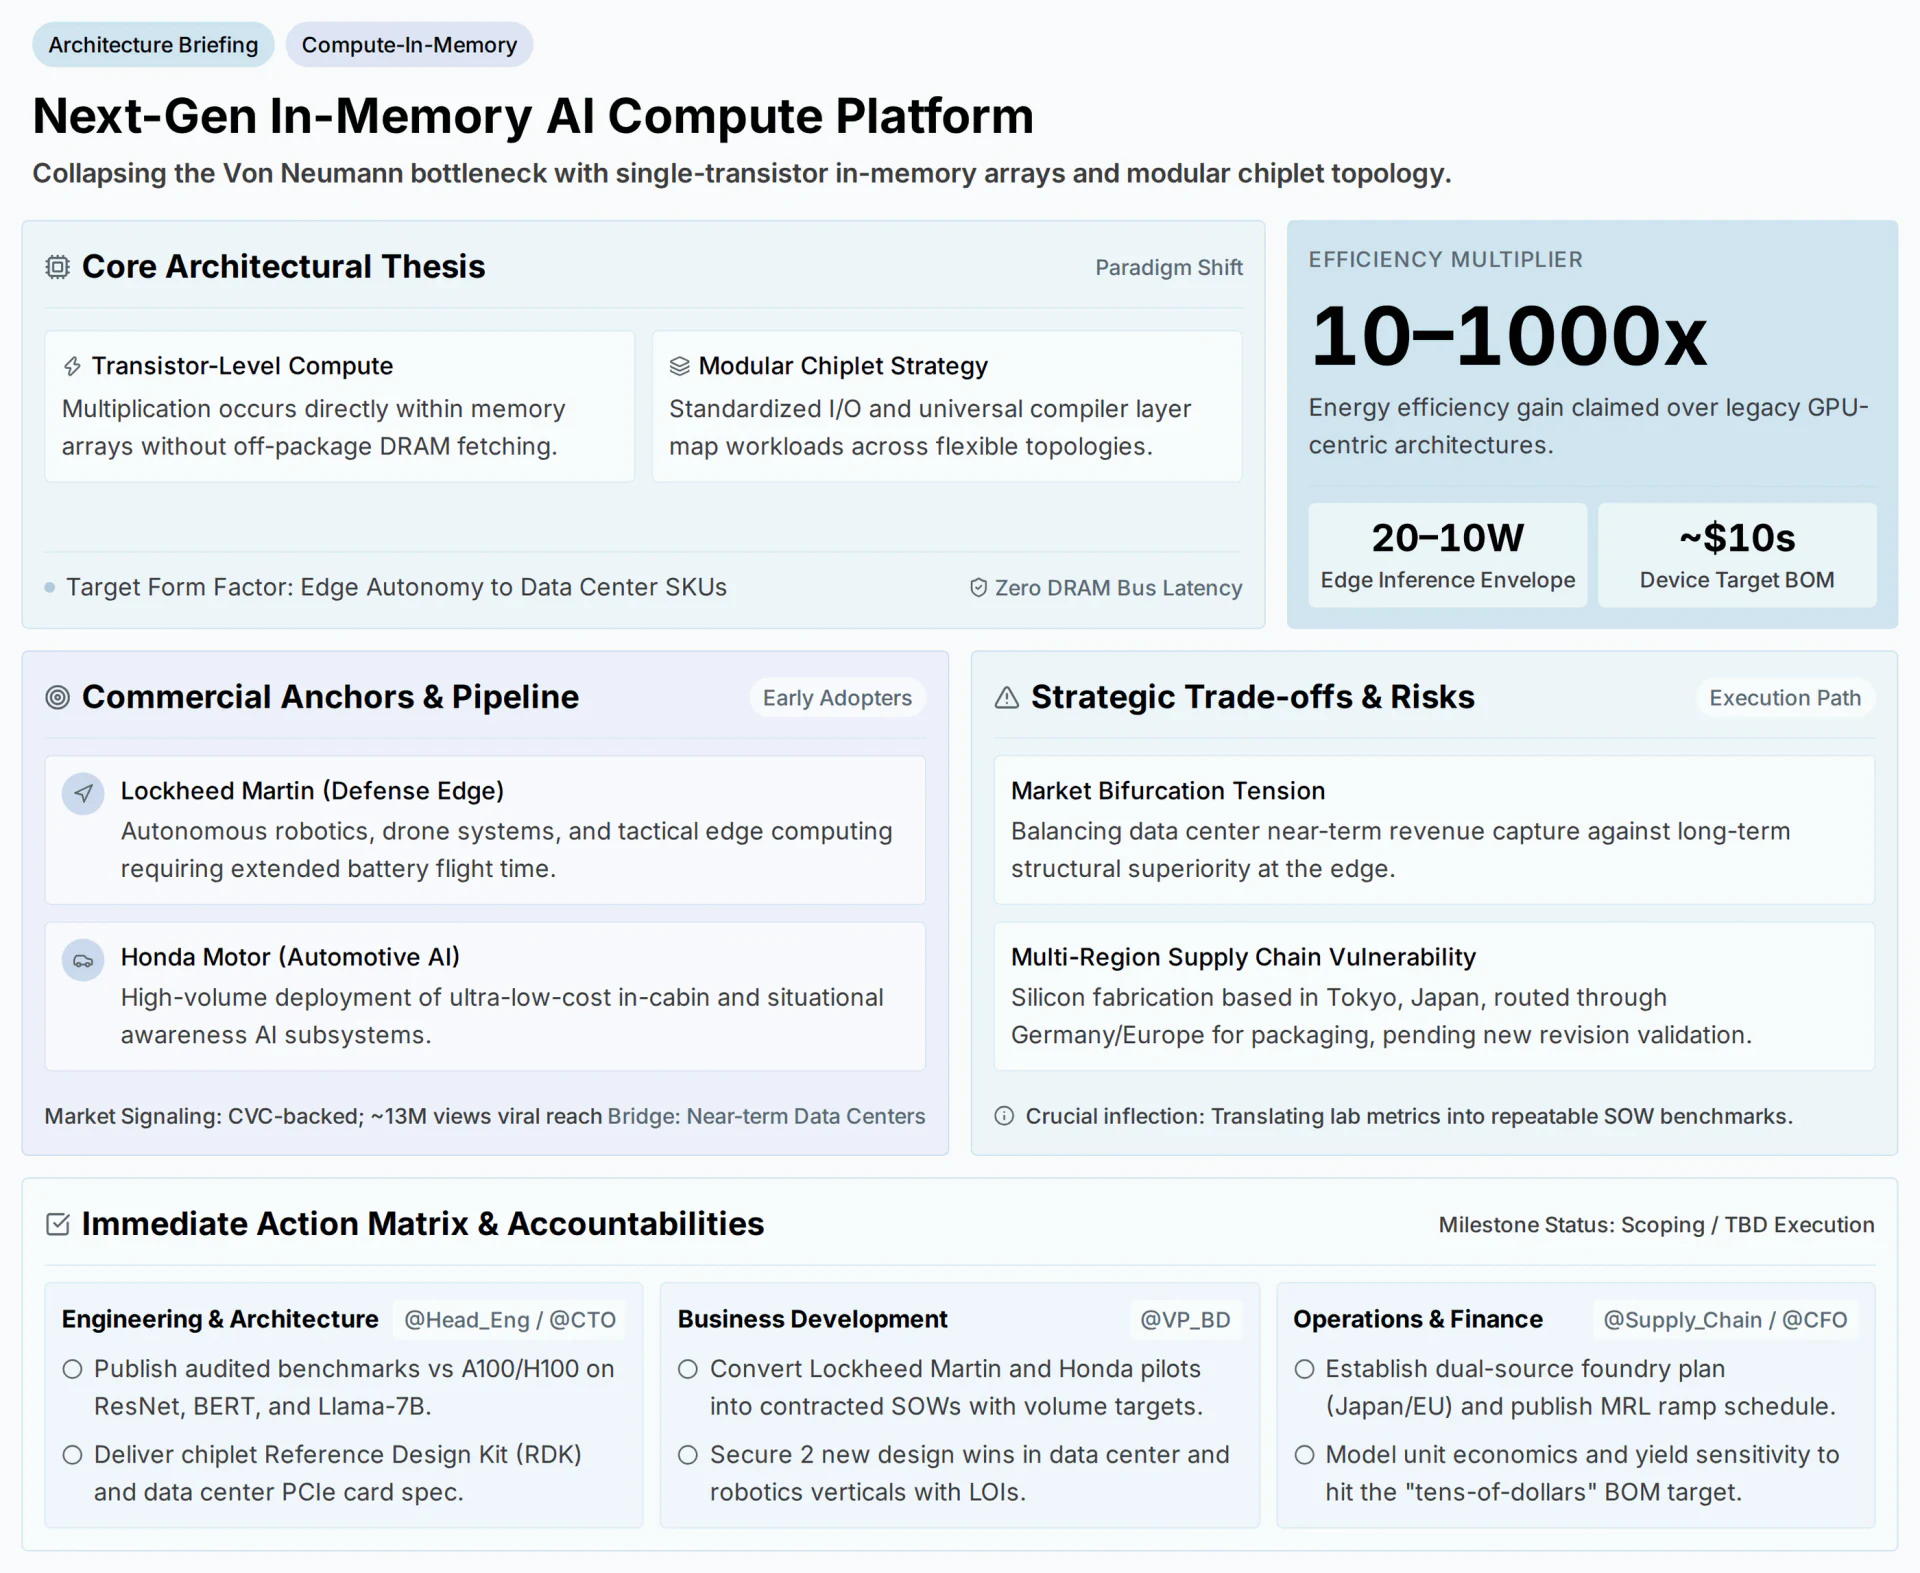
Aby rozwiązać problem termodynamicznego wąskiego gardła, Mythic AI rozwija filozofię architektoniczną, w której zamiast przerzucać dane między oddzielnymi jednostkami obliczeniowymi a pulami pamięci, sama pamięć musi stać się komputerem.
 .class="img-fluid clearfix"
Fizyka mnożenia macierzy na pojedynczym tranzystorze #
W klasycznych obliczeniach cyfrowych obliczenie iloczynu skalarnego macierzy wymaga pobrania tysięcy 8- lub 16-bitowych wartości wag z zewnętrznej pamięci DRAM przez linie magistrali o dużej pojemności, załadowania ich do rejestrów pamięci podręcznej, wykonania mnożenia w cyfrowych jednostkach ALU i zapisania wyników z powrotem do pamięci. Ponad 90% energii zużywa się na ładowanie i rozładowywanie miedzianych połączeń między układami.
Architektury obliczeń w pamięci zastępują ten cyfrowy transfer danych fizyką obwodów analogowych:
Programowanie wag. Wagi sieci neuronowej programuje się bezpośrednio w nieulotnych komórkach pamięci (takich jak zmodyfikowana pamięć flash lub rezystancyjna pamięć RAM) jako analogowe konduktancje ($G$). Po zaprogramowaniu wagi pozostają nieruchomo w macierzy pamięci; podczas wnioskowania nigdy nie są pobierane ani przenoszone.
Modulacja napięcia wejściowego. Aktywacje wejściowe (na przykład tokeny wizualne z kamer) zamienia się na analogowe poziomy napięcia ($V$) i podaje wzdłuż linii słów macierzy.
Mnożenie zgodnie z prawem Ohma. Gdy napięcie wejściowe przechodzi przez każdą komórkę pamięci, prawo Ohma ($I = V \times G$) wykonuje natychmiastowe mnożenie analogowe, wytwarzając prąd elektryczny proporcjonalny do iloczynu wejścia i zapisanej wagi.
Akumulacja zgodnie z prądowym prawem Kirchhoffa. Wzdłuż pionowych linii bitów prądy z tysięcy równoległych komórek pamięci w naturalny sposób sumują się zgodnie z prądowym prawem Kirchhoffa ($\sum I = 0$).
Pojedyncza macierz pamięci flash wykonuje więc całe mnożenie macierzy przez wektor w jednym cyklu zegara, na poziomie fizyki i bez ani jednego pobrania z pamięci. Zakumulowany prąd analogowy jest następnie zamieniany z powrotem na wartości cyfrowe przez szybkie przetworniki analogowo-cyfrowe (ADC) na krawędzi macierzy.
Modułowa strategia chipletów #
Analogowe obliczenia w pamięci rozwiązują równania energii i opóźnień, ale skalowanie krzemu w różnych dziedzinach komercyjnych wymaga elastyczności obudowy. Zamiast wytwarzać duże, monolityczne układy typu system-on-chip (SoC), które cierpią z powodu wykładniczo rosnącej liczby defektów, słabego uzysku z płytek i mało elastycznych konfiguracji produktów, Ozcelik przedstawił modułową strategię chipletów.
W tym modelu małe, ustandaryzowane kafelki obliczeniowe w pamięci wytwarza się niezależnie i łączy na interposerach przy użyciu zaawansowanych technik montażu:
- Ustandaryzowane szybkie połączenia między strukturami: Dzięki nowym standardom, takim jak Universal Chiplet Interconnect Express (UCIe), chiplety komunikują się przez mikrowyprowadzenia z dużą gęstością przepustowości i opóźnieniami rzędu pikosekund.
- Heterogeniczna kompozycja: Projektant systemu może połączyć dwa chiplety obliczeniowe w pamięci z tanim procesorem sterującym ARM dla lekkiego ładunku drona albo zestawić szesnaście chipletów z szybkimi interfejsami PCIe, tworząc kartę akceleracyjną dla serwerów w brzegowych centrach danych.
- Uniwersalna kompilacja i mapowanie obciążeń: Ujednolicona warstwa kompilatora przyjmuje standardowe grafy uczenia głębokiego (ONNX, PyTorch) i automatycznie rozdziela warstwy modelu na dostępną topologię chipletów, optymalizując trasowanie danych tak, by ograniczyć komunikację między chipletami.
Porównanie architektur: paradygmaty obliczeniowe dla robotyki brzegowej #
| Wymiar architektury | Standardowy cyfrowy GPU (NVIDIA Jetson / Orin) | Dedykowany brzegowy NPU (Google Coral / Hailo) | Analogowy chiplet obliczeń w pamięci (Mythic AI) |
|---|---|---|---|
| Mechanizm działania | Cyfrowe rdzenie SIMD/tensorowe pobierające wagi z LPDDR5/HBM | Cyfrowe macierze systoliczne z pamięcią podręczną wag w SRAM na układzie | Analogowe macierze z jednym tranzystorem na komórkę mnożące macierze na miejscu |
| Narzut przenoszenia danych | Wysoki (ciągłe ładowanie magistrali DRAM/SRAM; ponad 85% marnowanej energii) | Umiarkowany (ograniczony pojemnością wewnętrznej pamięci podręcznej SRAM) | Brak wewnętrznego przenoszenia danych; wagi pozostają na stałe w pamięci |
| Budżet mocy wnioskowania | 30–75 W+ (wymaga aktywnego chłodzenia wentylatorem i ciężkich radiatorów) | 5–15 W (chłodzenie pasywne lub minimalne) | 10–20 W (bardzo zwarte pasywne odprowadzanie ciepła) |
| Efektywność energetyczna (TOPS/W) | 2–5 TOPS/W (na poziomie systemu) | 10–25 TOPS/W | 50–200+ TOPS/W (teoretycznie 10x–1000x efektywności) |
| Koszt komponentów urządzenia (BOM) | £500–£2500+ za moduł obliczeniowy | £100–£350 za płytkę akceleratora | Kilkadziesiąt dolarów za chiplet przy produkcji seryjnej |
| Wąskie gardło pamięci (von Neumann) | Poważne; ograniczone przepustowością pamięci (GB/s do TB/s) | Umiarkowane; ograniczone pojemnością SRAM na układzie (MB) | Nie istnieje; przepustowość macierzy odpowiada wewnętrznej macierzy pamięci |
| Docelowa dziedzina wdrożeń | Pojazdy autonomiczne klasy premium i roboty do inspekcji przemysłowej | Inteligentne kamery i lekkie wbudowane urządzenia IoT | Robotyka dotykowa o wysokiej częstotliwości, drony taktyczne i AI w motoryzacji |
Źródło: synteza danych z rozmowy i specyfikacji architektury półprzewodników przedstawionych na Economist Enterprise Physical AI and Robotics Summit (Convene 200 Aldersgate, Londyn, 13 października 2026 r.).
Co to oznacza dla poszczególnych sektorów #
Komercyjne potwierdzenie obliczeń w pamięci zależy od wejścia do branż, w których ograniczenia mocy i kosztów historycznie blokowały wdrażanie zaawansowanych modeli bazowych.
Obronność taktyczna i systemy bezzałogowe #
W obronnych zastosowaniach brzegowych efektywność energetyczna przekłada się wprost na przetrwanie w działaniu i czas trwania misji. Małe bezzałogowe systemy powietrzne (sUAS) i taktyczne pojazdy naziemne są mocno ograniczone masą baterii. Wyposażenie drona rozpoznawczego w konwencjonalny GPU skraca jego czas lotu o 30–50% wyłącznie po to, by zasilić warstwę percepcji AI.
Strategiczna współpraca Mythic AI z Lockheed Martin koncentruje się na wbudowaniu obliczeń w pamięci w taktyczne systemy brzegowe, autonomiczne roje dronów i odległe posterunki obserwacyjne. Dzięki zmniejszeniu poboru mocy obliczeń z 50 W do poniżej 10 W drony taktyczne zyskują dłuższy czas lotu, a jednocześnie lokalnie wykonują wielomodalną klasyfikację obiektów, przetwarzanie sygnałów walki elektronicznej i odometrię wizualno-inercyjną na zakłócanych teatrach działań bez GPS.
Świadomość sytuacyjna pojazdów i AI w kabinie #
W motoryzacji dostawcy pierwszego rzędu mierzą się z silną presją na marże. Flagowe pojazdy elektryczne mogą udźwignąć koszt chłodzonych cieczą komputerów do jazdy autonomicznej za £2000, ale pojazdy masowe już nie.
Partnerstwo Honda Motor z Mythic AI odpowiada właśnie na to tarcie handlowe. Producenci samochodów potrzebują wielkoseryjnych, motoryzacyjnie kwalifikowanych układów AI kosztujących kilkadziesiąt, a nie kilkaset dolarów, zdolnych obsługiwać systemy monitorowania kierowcy, segmentację obiektów w martwym polu i percepcję otoczenia w 360 stopniach bez złożonych obiegów chłodzenia cieczą, które podnoszą koszt produkcji i komplikują montaż.
Przemysłowe brzegowe centra danych i mobilna realizacja zamówień #
Choć obliczenia w pamięci są architektonicznie zoptymalizowane pod brzeg, Mythic świadomie realizuje strategię pomostową, oferując karty akceleracyjne PCIe dla brzegowych centrów danych i centrów realizacji zamówień w magazynach. W obiektach obsługujących setki autonomicznych robotów mobilnych (AMR) szafy serwerowe na brzegu, uruchamiające modele koordynacji floty, są ograniczone przyłączami elektrycznymi obiektu i limitami chłodzenia. Karty akceleracyjne obliczeń w pamięci pozwalają zwielokrotnić lokalną przepustowość wnioskowania bez rozbudowy przyłącza energetycznego.
Odporność łańcucha dostaw i geografia produkcji #
Ważna część wystąpienia Ozcelika dotyczyła suwerenności łańcucha dostaw. Innowacja sprzętowa nic nie znaczy, jeśli krzemu nie da się niezawodnie wytwarzać, montować i wysyłać na dużą skalę.
Mythic AI zbudował rozproszoną międzynarodową sieć produkcyjną:
- Wytwarzanie krzemu: Podstawowa produkcja płytek do obliczeń w pamięci jest zakotwiczona w Tokio w Japonii, z wykorzystaniem ugruntowanej pozycji Japonii w precyzyjnym wytwarzaniu półprzewodników i dojrzałych węzłów procesowych dla pamięci analogowych i flash.
- Zaawansowany montaż i obudowywanie: Płytki trafiają do Europy (konkretnie do Niemiec) na zaawansowane cięcie chipletów, łączenie wielu struktur na podłożu i zautomatyzowaną inspekcję optyczną.
- Walidacja rewizji: Firma kończy walidację najnowszej rewizji krzemu, skupiając się na przełożeniu laboratoryjnych wskaźników uzysku na powtarzalne, produkcyjne zakresy prac (SOW) dla seryjnej produkcji motoryzacyjnej i obronnej.
To wieloregionalne podejście pozwala uniknąć pojedynczych punktów geopolitycznej podatności i zapewnia europejskim oraz azjatyckim partnerom korporacyjnym geograficznie zdywersyfikowane łańcuchy dostaw.
Wnioski #
Rozmowa Tanera Ozcelika i Kennetha Cukiera na Economist Enterprise Physical AI and Robotics Summit zarysowała fizyczną rzeczywistość, która będzie rządzić systemami autonomicznymi w nadchodzącej dekadzie. Prawo Moore’a, jako prosta miara skalowania tranzystorów, nie wystarcza już, by napędzać rewolucję fizycznej AI.
Dopóki architektury obliczeniowe trzymają się von Neumannowskiego rozdzielenia logiki i pamięci, robotyka pozostanie ograniczona masą baterii, odprowadzaniem ciepła i zaporowymi kosztami komponentów. Przechodząc od cyfrowego przenoszenia danych do analogowych macierzy obliczeń w pamięci i modułowych topologii chipletów, inżynieria półprzewodników dostarcza skokowego wzrostu efektywności, którego potrzebują systemy autonomiczne.
Przejście od klastrów centrów danych o mocy 700 W do brzegowego krzemu o mocy 15 W to prawdziwa brama do fizycznej autonomii. Ostatecznie roboty działające w realnym świecie muszą podlegać jego prawom energetycznym; obliczenia w pamięci to architektura, która łączy krzem z biologią.
Najczęściej zadawane pytania #
Czym jest wąskie gardło von Neumanna w sprzęcie AI? Wąskie gardło von Neumanna to ograniczenie przepustowości i energii wynikające z fizycznego rozdzielenia jednostki obliczeniowej (ALU) i pamięci systemowej (DRAM). W obciążeniach sztucznej inteligencji, obejmujących miliardy mnożeń macierzy, procesory zużywają ponad 85% całkowitej energii i znaczną liczbę cykli zegara na samo przerzucanie danych tam i z powrotem po miedzianych magistralach, co tworzy poważne wąskie gardła termiczne i opóźnieniowe.
Jak działają analogowe obliczenia w pamięci (CIM)? Obliczenia w pamięci wykonują operacje matematyczne bezpośrednio w komórkach pamięci, bez przenoszenia danych. Wagi sieci neuronowej są przechowywane jako analogowe stany konduktancji w nieulotnych komórkach pamięci. Gdy do macierzy przykłada się napięcia wejściowe, prąd płynie przez komórki zgodnie z prawem Ohma ($I = V \times G$) i sumuje się wzdłuż linii bitów zgodnie z prądowym prawem Kirchhoffa. W ten sposób pełne mnożenie macierzy przez wektor odbywa się w jednym kroku fizycznym.
Dlaczego obliczenia w pamięci są szczególnie ważne dla robotów i dronów? Roboty mobilne i drony działają pod ścisłymi ograniczeniami SWaP-C (rozmiar, waga, moc i koszt). Polegają na bateriach pokładowych i nie mogą przenosić ciężkich chłodnic ani zasilaczy dużej mocy. Obliczenia w pamięci zapewniają od 10x do 1000x wyższą efektywność energetyczną, dzięki czemu roboty mogą lokalnie uruchamiać złożone modele wizja-język-działanie w budżecie mocy 10–20 W, zachowując czas pracy baterii.
Jaka jest przewaga chipletów nad układem monolitycznym? Układy monolityczne integrują wszystkie jednostki funkcjonalne na jednej, dużej strukturze krzemowej. Wraz ze wzrostem rozmiaru struktury liczba defektów produkcyjnych rośnie wykładniczo, co obniża uzysk i podnosi koszt jednostkowy. Architektura chipletowa dzieli system na mniejsze, ustandaryzowane struktury krzemowe, wytwarzane niezależnie z wysokim uzyskiem i łączone szybkimi mikrowyprowadzeniami. Pozwala to tworzyć modułowe, elastyczne konfiguracje dopasowane do konkretnych przemysłowych wymagań dotyczących mocy i formatu.
Kim są główni partnerzy komercyjni tej technologii? Platforma obliczeń w pamięci Mythic AI opiera się obecnie na dwóch dużych partnerstwach korporacyjnych: z Lockheed Martin, który integruje tę architekturę z taktycznymi dronami obronnymi, bezzałogowymi platformami robotycznymi i posterunkami ochrony perymetru, aby wydłużyć czas pracy baterii, oraz z Honda Motor, która celuje w tanie, motoryzacyjnie kwalifikowane układy AI do świadomości sytuacyjnej pojazdów i czujników we wnętrzu kabiny.
Bibliografia #
- Economist Enterprise, (2026). Physical AI & Robotics Summit: przewaga operacyjna dzięki systemom autonomicznym ⧉. Economist Enterprise.
- Ozcelik, T., (2026). Poza prawem Moore’a: moc stojąca za wydajną robotyką ⧉. Mythic AI.
- Cukier, K., (2026). Termodynamiczne granice autonomicznej inteligencji ⧉. The Economist.
- Marković, D., Mizrahi, A., Querlioz, D. i Grollier, J., (2020). Fizyka dla obliczeń neuromorficznych ⧉. Nature Reviews Physics, 2, 499-510.
- Universal Chiplet Interconnect Express, (2025). Specyfikacja UCIe 2.0: standard połączeń między strukturami ⧉. UCIe Consortium.
- IEEE, (2026). International Roadmap for Devices and Systems (IRDS): poza CMOS i obliczenia w pamięci ⧉. IEEE Standards Association.
Ostatnia weryfikacja .
Ostatnia weryfikacja .
Opublikuj ten artykuł ponownie
Kopiuj format dla Medium
# Obliczenia w pamięci i chiplety: robotyka brzegowa poza prawem Moore’a — Sebastien Rousseau

> Originally published at [https://sebastienrousseau.com/pl/2026-10-13-obliczenia-pamieci-chiplety-robotyka-brzegowa-poza/](https://sebastienrousseau.com/pl/2026-10-13-obliczenia-pamieci-chiplety-robotyka-brzegowa-poza/)

Taner Ozcelik, prezes Mythic AI, pokazał na szczycie Economist w Londynie, jak obliczenia w pamięci i modułowe chiplety burzą ścianę pamięci von Neumanna w robotyce.

Read the full article on sebastienrousseau.com: https://sebastienrousseau.com/pl/2026-10-13-obliczenia-pamieci-chiplety-robotyka-brzegowa-poza/
Kopiuj format dla Mastodon
Obliczenia w pamięci i chiplety: robotyka brzegowa poza prawem Moore’a — Sebastien Rousseau

Taner Ozcelik, prezes Mythic AI, pokazał na szczycie Economist w Londynie, jak obliczenia w pamięci i modułowe chiplety burzą ścianę pamięci von Neumanna w robotyce.

https://sebastienrousseau.com/pl/2026-10-13-obliczenia-pamieci-chiplety-robotyka-brzegowa-poza/
Skopiuj sformatowane dla LinkedIn
Obliczenia w pamięci i chiplety: robotyka brzegowa poza prawem Moore’a — Sebastien Rousseau

Taner Ozcelik, prezes Mythic AI, pokazał na szczycie Economist w Londynie, jak obliczenia w pamięci i modułowe chiplety burzą ścianę pamięci von Neumanna w robotyce.

Oto kluczowe strategiczne wnioski:

- Ściana termodynamiczna: dlaczego fizyczna AI nie może żyć w chmurze. Podczas rozmowy zatytułowanej Moving past Moore’s law: the power behind high-performance robotics (Poza prawem Moore’a: moc stojąca za wydajną robotyką) Kenneth Cukier nakreślił zasadniczy dylemat inżynieryjny…
- Teza architektoniczna: obliczenia w pamięci (CIM). Aby rozwiązać problem termodynamicznego wąskiego gardła, Mythic AI rozwija filozofię architektoniczną, w której zamiast przerzucać dane między oddzielnymi jednostkami obliczeniowymi a pulami pamięci, sama pamięć musi…
- Modułowa strategia chipletów. Analogowe obliczenia w pamięci rozwiązują równania energii i opóźnień, ale skalowanie krzemu w różnych dziedzinach komercyjnych wymaga elastyczności obudowy.
- Porównanie architektur: paradygmaty obliczeniowe dla robotyki brzegowej. Źródło: synteza danych z rozmowy i specyfikacji architektury półprzewodników przedstawionych na Economist Enterprise Physical AI and Robotics Summit (Convene 200 Aldersgate, Londyn, 13 października 2026 r.).

Jakie jest podejście Twojej organizacji do wyzwań opisanych w tym artykule?

→ https://sebastienrousseau.com/pl/2026-10-13-obliczenia-pamieci-chiplety-robotyka-brzegowa-poza/

#ObliczeniaWPamięci #MythicAi #TanerOzcelik #PrawoMoore’a #WąskieGardłoVonNeumanna

Sebastien Rousseau | CC-BY-4.0
Zacytuj ten artykuł
Obliczenia w pamięci i chiplety: robotyka brzegowa poza prawem Moore’a — Sebastien Rousseau
Taner Ozcelik, prezes Mythic AI, pokazał na szczycie Economist w Londynie, jak obliczenia w pamięci i modułowe chiplety burzą ścianę pamięci von Neumanna w robotyce.
BibTeX
@online{rousseau2026obliczenia,
  author  = {Rousseau, Sebastien},
  title   = {{Obliczenia w pamięci i chiplety: robotyka brzegowa poza prawem Moore’a — Sebastien Rousseau}},
  year    = {2026},
  url     = {https://sebastienrousseau.com/pl/2026-10-13-obliczenia-pamieci-chiplety-robotyka-brzegowa-poza/},
  urldate = {2026}
}RIS
TY  - GEN
AU  - Rousseau, Sebastien
TI  - Obliczenia w pamięci i chiplety: robotyka brzegowa poza prawem Moore’a — Sebastien Rousseau
PY  - 2026
UR  - https://sebastienrousseau.com/pl/2026-10-13-obliczenia-pamieci-chiplety-robotyka-brzegowa-poza/
ER  -
Vancouver
Rousseau S. Obliczenia w pamięci i chiplety: robotyka brzegowa poza prawem Moore’a — Sebastien Rousseau. sebastienrousseau.com. 2026 Oct 13. Available from: https://sebastienrousseau.com/pl/2026-10-13-obliczenia-pamieci-chiplety-robotyka-brzegowa-poza/
Chicago
Rousseau, Sebastien. "Obliczenia w pamięci i chiplety: robotyka brzegowa poza prawem Moore’a — Sebastien Rousseau." sebastienrousseau.com. October 13, 2026. https://sebastienrousseau.com/pl/2026-10-13-obliczenia-pamieci-chiplety-robotyka-brzegowa-poza/.
APA
Rousseau, S. (2026, October 13). Obliczenia w pamięci i chiplety: robotyka brzegowa poza prawem Moore’a — Sebastien Rousseau. sebastienrousseau.com. https://sebastienrousseau.com/pl/2026-10-13-obliczenia-pamieci-chiplety-robotyka-brzegowa-poza/
Opublikuj ponownie ten artykuł
Obliczenia w pamięci i chiplety: robotyka brzegowa poza prawem Moore’a — Sebastien Rousseau
Taner Ozcelik, prezes Mythic AI, pokazał na szczycie Economist w Londynie, jak obliczenia w pamięci i modułowe chiplety burzą ścianę pamięci von Neumanna w robotyce.
Ten artykuł jest objęty licencją Creative Commons Attribution 4.0 International. Ponowna publikacja wymaga przypisania do kanonicznego adresu URL.
Obliczenia w pamięci i chiplety: robotyka brzegowa poza prawem Moore’a — Sebastien Rousseau

Taner Ozcelik, prezes Mythic AI, pokazał na szczycie Economist w Londynie, jak obliczenia w pamięci i modułowe chiplety burzą ścianę pamięci von Neumanna w robotyce.

Originally published at https://sebastienrousseau.com/pl/2026-10-13-obliczenia-pamieci-chiplety-robotyka-brzegowa-poza/ by Sebastien Rousseau.
Licensed under CC-BY-4.0.