
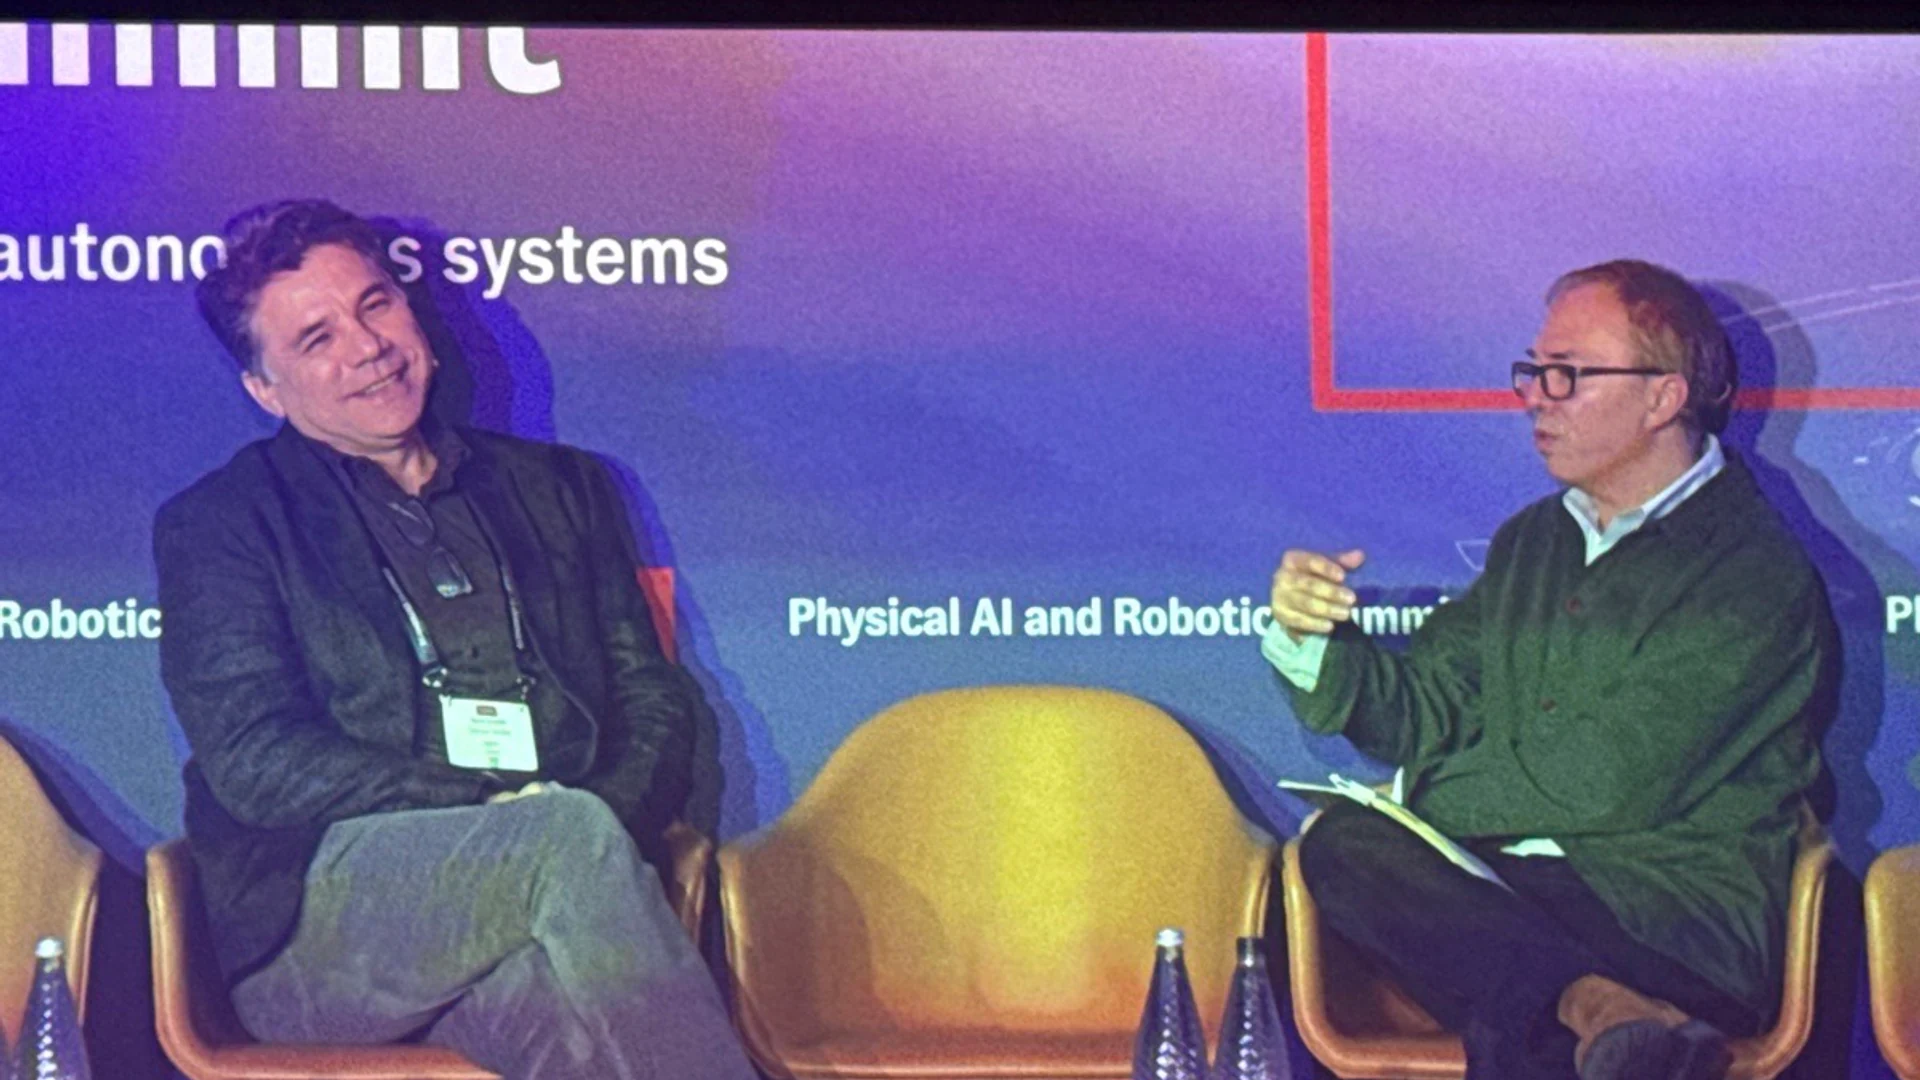
Per oltre mezzo secolo il progresso dell'informatica ha seguito la legge di Moore: raddoppiare il numero di transistor sul silicio ogni diciotto-ventiquattro mesi. Ma nel campo emergente dell'IA fisica e della robotica autonoma, la legge di Moore si è scontrata con le leggi della termodinamica. Droni autonomi, robot quadrupedi, manipolatori chirurgici e veicoli a guida autonoma non possono portarsi dietro GPU di classe server da 700 watt né torri di raffreddamento. Al summit Physical AI and Robotics di Economist Enterprise, a Londra il 13 ottobre 2026, Taner Ozcelik, presidente e amministratore delegato di Mythic AI, ha conversato con Kenneth Cukier in un incontro informale sulla rivoluzione architetturale necessaria per uscire da questo stallo: andare oltre la legge di Moore con il calcolo analogico in memoria (CIM) e i chiplet modulari.
Il muro termodinamico: perché l'IA fisica non può vivere nel cloud #
Nella sessione intitolata Moving past Moore’s law: the power behind high-performance robotics, Kenneth Cukier ha inquadrato il dilemma ingegneristico centrale dell'autonomia aziendale: i modelli di intelligenza artificiale crescono per numero di parametri e capacità percettive, ma le macchine fisiche operano sotto vincoli SWaP-C spietati (dimensioni, peso, potenza e costo).
L'attuale frontiera dell'IA poggia su data center hyperscale che assorbono 150 megawatt o più attraverso enormi cluster di server. Come ha osservato Ozcelik, questa architettura lavora su scale energetiche lontane milioni di volte dai riferimenti biologici. Il cervello umano svolge in tempo reale la coordinazione sensomotoria continua, il ragionamento semantico e la navigazione visuo-spaziale con un budget metabolico di circa 20 watt.
In passato gli ingegneri robotici hanno cercato di aggirare i limiti del calcolo a bordo delegando l'inferenza al cloud. Ma negli ambienti industriali, aerospaziali e della difesa in cui la missione è critica, un'autonomia dipendente dal cloud è un'impossibilità architetturale:
- Variabilità della latenza e jitter: il controllo robotico ad anello chiuso ad alta velocità richiede aggiornamenti deterministici dei motori tra 50 Hz e 1.000 Hz (andata e ritorno sotto i 20 millisecondi). Le reti cellulari e Wi-Fi introducono jitter, frame persi e picchi di latenza che fanno cadere i pezzi ai bracci robotici o mancare le soglie di frenata ai veicoli autonomi.
- Saturazione della banda: trasmettere più flussi video 4K non compressi e nuvole di punti LiDAR da decine di robot mobili in uno stabilimento esaurisce presto la banda radio locale e comporta costi di uscita dal cloud esorbitanti.
- Sovranità operativa e connettività contesa: nelle miniere sotterranee, nelle gallerie senza GPS, nei cantieri isolati o negli scenari militari tattici, i collegamenti di rete esterni non esistono o sono disturbati attivamente. I sistemi autonomi devono portare tutta la loro intelligenza operativa direttamente sul telaio all'edge.
Dotare i robot di GPU standard ad alte prestazioni comporta a sua volta penalità fisiche: throttling termico, dissipatori enormi che aggiungono massa parassita al carico utile e consumi elevati che riducono l'autonomia di volo da ore a minuti.
La tesi architetturale: il calcolo in memoria (CIM) #
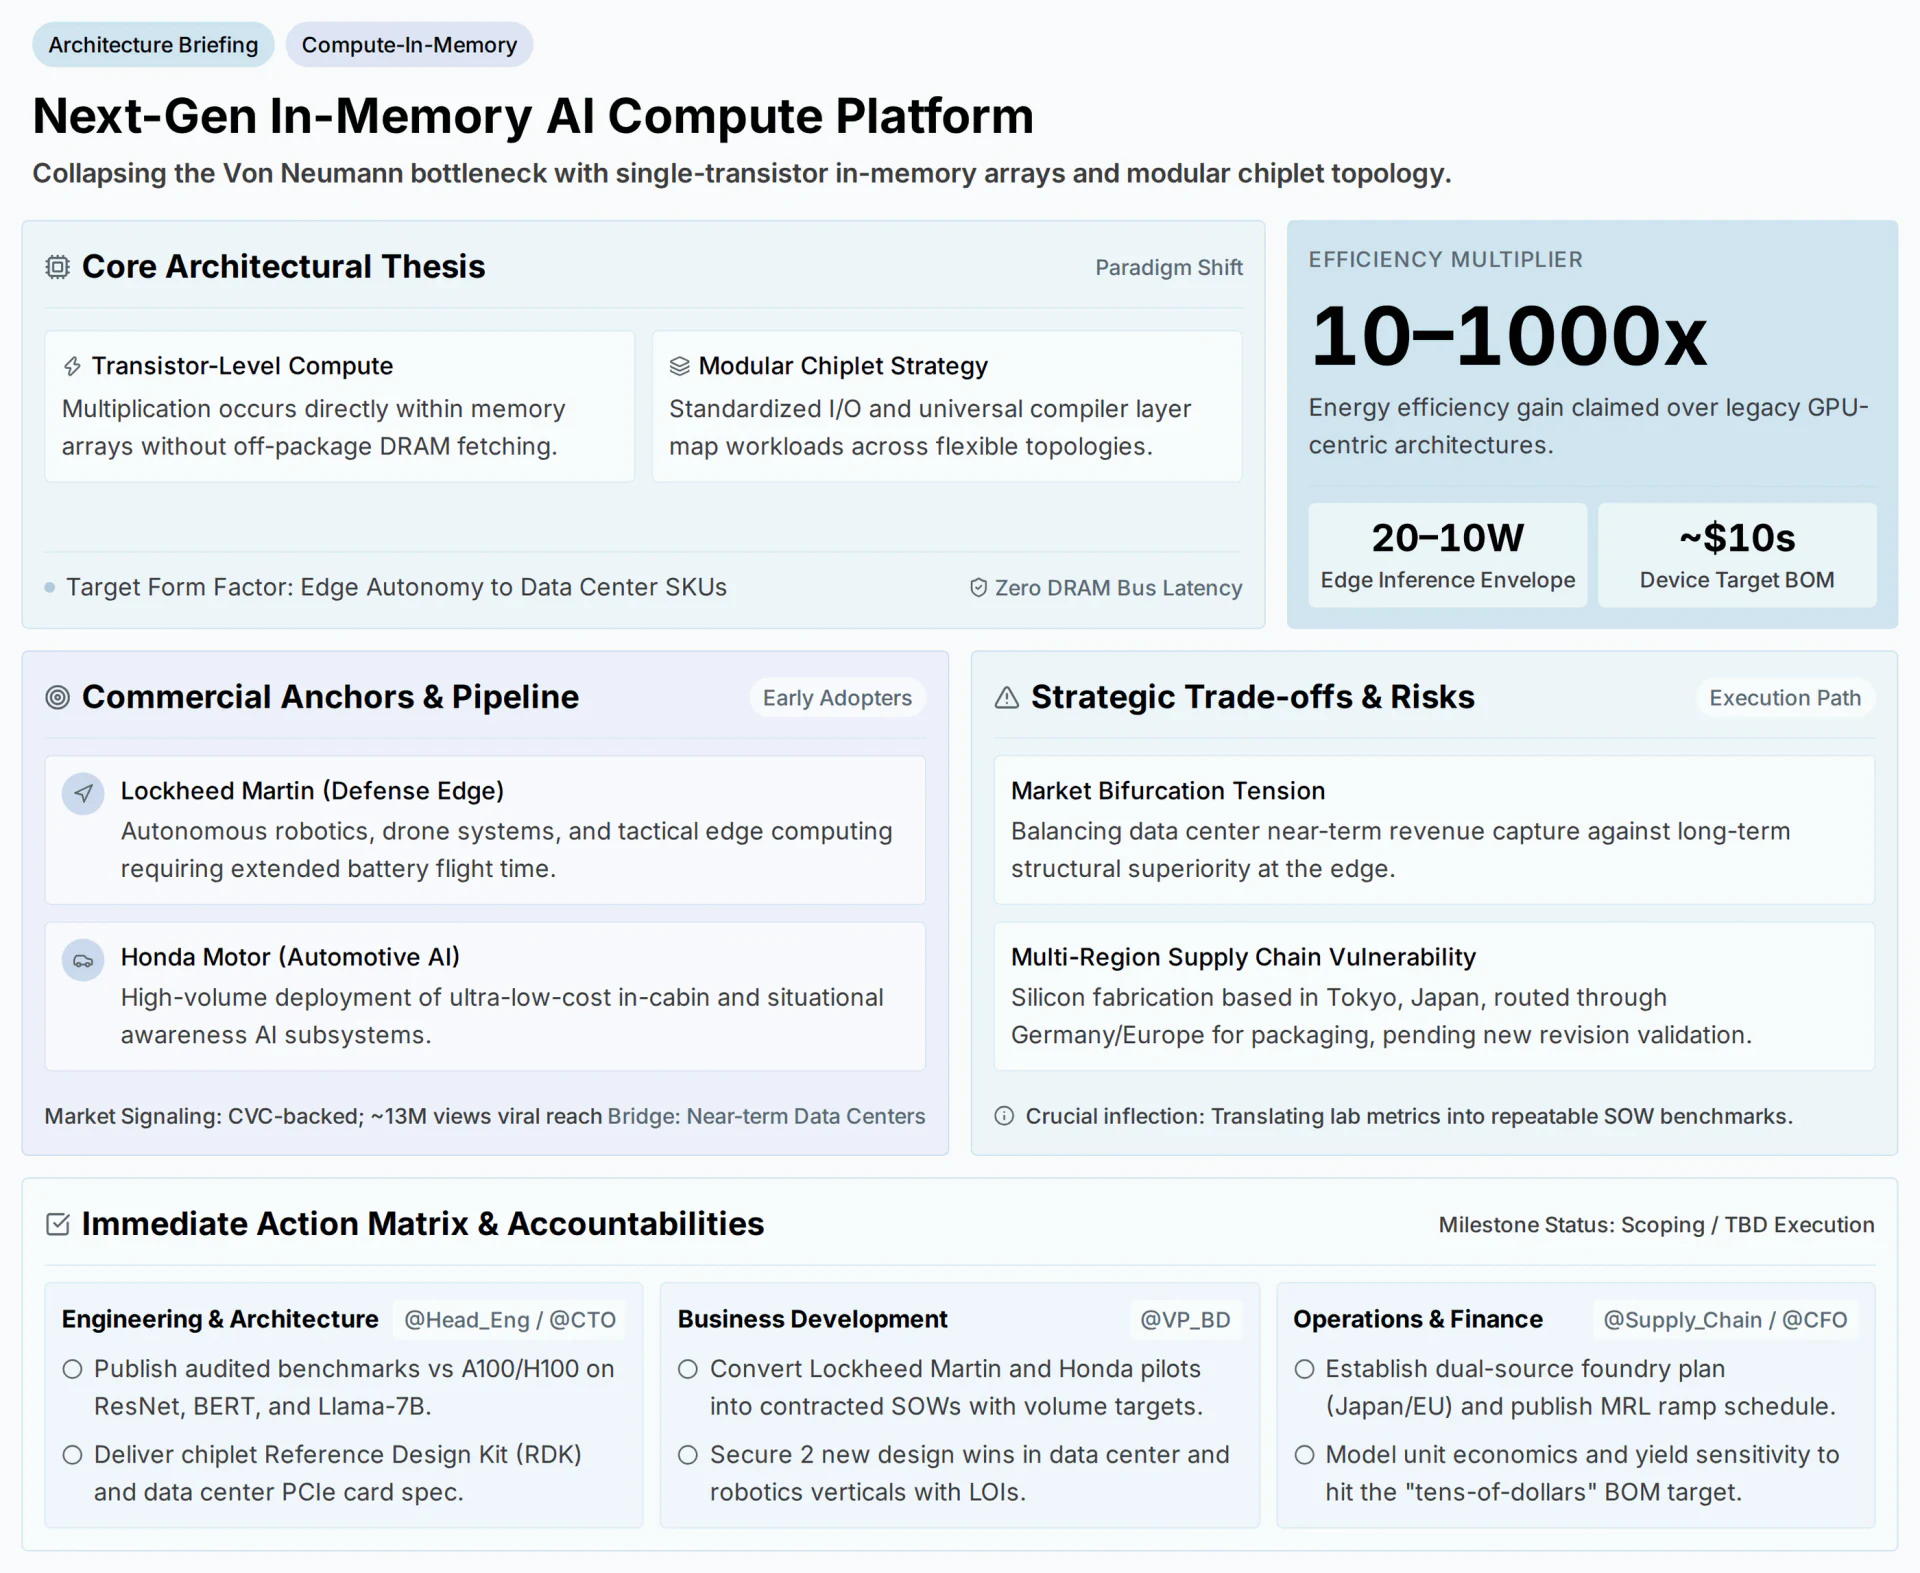
Per risolvere il collo di bottiglia termodinamico, Mythic AI ha sviluppato una filosofia architetturale: invece di far viaggiare i dati tra unità di elaborazione e banchi di memoria separati, è la memoria stessa a dover diventare il computer.
 .class="img-fluid clearfix"
La fisica della moltiplicazione matriciale a singolo transistor #
Nell'informatica digitale classica, calcolare un prodotto scalare matriciale richiede di prelevare migliaia di pesi a 8 o 16 bit da una DRAM esterna tramite linee di bus ad alta capacità, caricarli nei registri di cache, eseguire la moltiplicazione nelle ALU digitali e riscrivere i risultati in memoria. Oltre il 90 % dell'energia viene speso per caricare e scaricare le interconnessioni in rame tra i chip.
Le architetture di calcolo in memoria sostituiscono questo trasferimento digitale di dati con la fisica dei circuiti analogici:
Programmazione dei pesi. I pesi della rete neurale vengono programmati direttamente in celle di memoria non volatile (come flash modificata o RAM resistiva) sotto forma di conduttanze analogiche ($G$). Una volta programmati, i pesi restano fermi nella matrice di memoria; non vengono mai prelevati né trasferiti durante l'inferenza.
Modulazione della tensione d'ingresso. Le attivazioni d'ingresso (per esempio i token visivi provenienti dalle telecamere) vengono convertite in livelli di tensione analogici ($V$) e applicate alle linee di parola della matrice.
Moltiplicazione con la legge di Ohm. Quando la tensione d'ingresso attraversa ciascuna cella di memoria, la legge di Ohm ($I = V \times G$) esegue una moltiplicazione analogica istantanea e genera una corrente proporzionale al prodotto tra l'ingresso e il peso memorizzato.
Accumulo con la legge di Kirchhoff delle correnti. Lungo le linee di bit verticali, le correnti di migliaia di celle in parallelo si sommano naturalmente secondo la legge di Kirchhoff delle correnti ($\sum I = 0$).
Una sola matrice di memoria flash esegue così un'intera moltiplicazione matrice-vettore in un unico ciclo di clock, a livello fisico e senza un solo accesso alla memoria. La corrente analogica accumulata viene poi riconvertita in valori digitali da convertitori analogico-digitali (ADC) veloci posti ai bordi della matrice.
La strategia dei chiplet modulari #
Se il calcolo analogico in memoria risolve le equazioni di energia e latenza, portare il silicio in settori commerciali molto diversi richiede flessibilità nel packaging. Invece di produrre grandi system-on-chip (SoC) monolitici, che soffrono di tassi di difetti esponenziali, rese per wafer scarse e configurazioni di prodotto rigide, Ozcelik ha illustrato una strategia a chiplet modulari.
In questo paradigma, piccoli tasselli standardizzati di calcolo in memoria vengono fabbricati separatamente e uniti su interposer con il packaging avanzato:
- Interconnessioni die-to-die standardizzate ad alta velocità: sfruttando standard emergenti come Universal Chiplet Interconnect Express (UCIe), i chiplet comunicano tramite micro-bump con un'elevata densità di banda e latenze nell'ordine dei picosecondi.
- Composizione eterogenea: un progettista può abbinare due chiplet in memoria a un processore di controllo ARM economico per il carico utile di un drone leggero, oppure assemblare sedici chiplet con interfacce PCIe veloci per creare una scheda acceleratrice server per data center edge.
- Compilazione universale e distribuzione dei carichi: un livello di compilazione unificato riceve grafi standard di deep learning (ONNX, PyTorch) e ripartisce automaticamente i livelli del modello sulla topologia di chiplet disponibile, ottimizzando l'instradamento dei dati per ridurre al minimo la comunicazione tra chiplet.
Confronto architetturale: paradigmi di calcolo per la robotica edge #
| Vettore architetturale | GPU digitale standard (NVIDIA Jetson / Orin) | NPU edge dedicata (Google Coral / Hailo) | Chiplet di calcolo analogico in memoria (Mythic AI) |
|---|---|---|---|
| Meccanismo di base | Core digitali SIMD/tensoriali che prelevano i pesi da LPDDR5/HBM | Matrici sistoliche digitali con cache dei pesi in SRAM on-chip | Matrici analogiche a singolo transistor che moltiplicano le matrici in situ |
| Costo dello spostamento dei dati | Alto (carica continua dei bus DRAM/SRAM; oltre l'85 % di energia sprecata) | Moderato (limitato dalla capacità della cache SRAM interna) | Nessuno spostamento interno; i pesi restano sempre in memoria |
| Budget di potenza per l'inferenza | Da 30 W a oltre 75 W (servono ventole attive e dissipatori pesanti) | Da 5 W a 15 W (raffreddamento passivo o minimo) | Da 10 W a 20 W (dissipazione termica passiva ultracompatta) |
| Efficienza energetica (TOPS/W) | Da 2 a 5 TOPS/watt (a livello di sistema) | Da 10 a 25 TOPS/watt | Da 50 a oltre 200 TOPS/watt (efficienza teorica da 10x a 1.000x) |
| Distinta base del componente (BOM) | Da 500 £ a oltre 2.500 £ per modulo di calcolo | Da 100 £ a 350 £ per scheda acceleratrice | Decine di dollari per chiplet in volume |
| Collo di bottiglia della memoria (Von Neumann) | Grave; limitato dalla banda di memoria (da GB/s a TB/s) | Moderato; limitato dalla capacità della SRAM on-chip (MB) | Inesistente; la banda della matrice coincide con quella della matrice di memoria interna |
| Ambito di impiego | Veicoli autonomi di fascia alta e robot per l'ispezione industriale | Telecamere intelligenti e dispositivi IoT embedded leggeri | Robotica tattile ad alta frequenza, droni tattici e IA per l'automotive |
Fonte: sintesi dei dati emersi dalla conversazione e delle specifiche di architettura dei semiconduttori presentate al summit Physical AI and Robotics di Economist Enterprise (Convene 200 Aldersgate, Londra, 13 ottobre 2026).
Cosa significa per i singoli settori #
La validazione commerciale del calcolo in memoria dipende dalla sua penetrazione nei settori in cui i vincoli di potenza e di costo hanno finora bloccato l'impiego di modelli di base avanzati.
Difesa tattica e sistemi senza pilota #
Nelle applicazioni di difesa all'edge, l'efficienza energetica si traduce direttamente in sopravvivenza operativa e durata della missione. I piccoli sistemi aerei senza pilota (sUAS) e i rover terrestri tattici sono fortemente vincolati dal peso della batteria. Dotare un drone da ricognizione di una GPU convenzionale riduce la sua autonomia di volo del 30-50 %, solo per alimentare lo stack di percezione dell'IA.
L'impegno strategico di Mythic AI con Lockheed Martin punta a integrare il calcolo in memoria in sistemi tattici all'edge, sciami di droni autonomi e posti di sorveglianza remoti. Riducendo l'assorbimento di calcolo da 50 W a meno di 10 W, i droni tattici volano più a lungo eseguendo localmente la classificazione multimodale degli oggetti, l'elaborazione dei segnali per la guerra elettronica e l'odometria visivo-inerziale, in teatri operativi contesi e privi di GPS.
Percezione dell'ambiente e IA di abitacolo nell'automotive #
Nel settore automobilistico, i fornitori di primo livello subiscono una forte compressione dei margini. Se le auto elettriche di punta possono assorbire il costo di computer per la guida autonoma raffreddati a liquido da 2.000 £, i veicoli di massa non possono.
La partnership di Honda Motor con Mythic AI affronta questo attrito commerciale. Le case automobilistiche hanno bisogno di chip IA qualificati per l'automotive, prodotti in grandi volumi e dal costo di decine di dollari anziché centinaia, capaci di gestire il monitoraggio del conducente, la segmentazione degli oggetti nell'angolo cieco e la percezione a 360 gradi, senza complessi circuiti di raffreddamento a liquido che aumentano i costi di produzione e la complessità di assemblaggio.
Data center industriali all'edge e logistica mobile #
Pur essendo ottimizzato per l'edge, il calcolo in memoria è al centro di una deliberata strategia ponte di Mythic, che offre schede acceleratrici PCIe per data center edge e centri logistici. Negli impianti che ospitano centinaia di robot mobili autonomi (AMR), i rack di server che eseguono i modelli di coordinamento della flotta sono limitati dagli allacci elettrici e dalla capacità di raffreddamento della struttura. Le schede acceleratrici in memoria permettono di moltiplicare il throughput di inferenza locale senza potenziare l'infrastruttura elettrica.
Resilienza della catena di fornitura e geografia della produzione #
Un aspetto cruciale dell'intervento di Ozcelik riguardava la sovranità della catena di fornitura. L'innovazione hardware non ha senso se il silicio non può essere prodotto, assemblato e spedito in modo affidabile su larga scala.
Mythic AI ha costruito una rete produttiva internazionale distribuita:
- Produzione del silicio: la produzione dei wafer di calcolo in memoria è concentrata a Tokyo, in Giappone, e sfrutta la consolidata leadership giapponese nella fabbricazione di semiconduttori di precisione e nodi di processo analogici e flash maturi.
- Packaging avanzato e assemblaggio: i wafer vengono inviati in Europa (precisamente in Germania) per il taglio avanzato dei chiplet, il bonding su substrati multi-die e l'ispezione ottica automatizzata.
- Validazione della revisione: l'azienda sta completando la validazione della sua ultima revisione di silicio, con l'obiettivo di tradurre le rese di laboratorio in capitolati di lavoro (SOW) ripetibili e di qualità produttiva per i volumi dell'automotive e della difesa.
Questo approccio su più regioni evita vulnerabilità geopolitiche concentrate in un solo punto e offre ai partner europei e asiatici catene di fornitura diversificate dal punto di vista geografico.
Conclusione #
La conversazione tra Taner Ozcelik e Kenneth Cukier al summit Physical AI and Robotics di Economist Enterprise ha delineato la realtà fisica che governerà il prossimo decennio dei sistemi autonomi. La legge di Moore, come semplice misura della scalabilità dei transistor, non basta più ad alimentare la rivoluzione dell'IA fisica.
Finché le architetture di calcolo resteranno legate alla separazione di Von Neumann tra logica e memoria, la robotica resterà vincolata dalla massa delle batterie, dalla dissipazione del calore e da costi della distinta base proibitivi. Passando dallo spostamento digitale dei dati alle matrici analogiche di calcolo in memoria e alle topologie a chiplet modulari, l'ingegneria dei semiconduttori sta producendo il salto di efficienza di cui i sistemi autonomi hanno bisogno.
Il passaggio da cluster di data center da 700 W a silicio edge da 15 W rappresenta la vera porta d'accesso all'autonomia fisica. In ultima analisi, i robot che operano nel mondo reale devono obbedire alle leggi energetiche del mondo reale; il calcolo in memoria è l'architettura che colma il divario tra silicio e biologia.
Domande frequenti #
Che cos'è il collo di bottiglia di Von Neumann nell'hardware per l'IA? Il collo di bottiglia di Von Neumann è il limite di throughput e di energia causato dalla separazione fisica tra l'unità di elaborazione (ALU) e la memoria di sistema (DRAM). Nei carichi di intelligenza artificiale, che comportano miliardi di moltiplicazioni matriciali, i processori spendono oltre l'85 % della loro energia totale e molti cicli di clock solo per spostare dati avanti e indietro sui bus in rame, creando gravi colli di bottiglia termici e di latenza.
Come funziona il calcolo analogico in memoria (CIM)? Il calcolo in memoria esegue le operazioni matematiche direttamente dentro le celle di memoria, senza spostare i dati. I pesi della rete neurale sono memorizzati come stati di conduttanza analogica in celle di memoria non volatile. Quando si applicano tensioni d'ingresso alla matrice, la corrente attraversa le celle secondo la legge di Ohm ($I = V \times G$) e si somma lungo le linee di bit secondo la legge di Kirchhoff delle correnti. Si ottiene così un'intera moltiplicazione matrice-vettore in un solo passaggio fisico.
Perché il calcolo in memoria è così importante per robot e droni? Robot mobili e droni operano sotto stretti vincoli di dimensioni, peso, potenza e costo (SWaP-C). Dipendono da batterie a bordo e non possono sostenere radiatori pesanti né alimentatori ad alta potenza. Il calcolo in memoria offre un'efficienza energetica da 10 a 1.000 volte superiore, che consente ai robot di eseguire localmente modelli complessi visione-linguaggio-azione in un budget di 10-20 W senza sacrificare l'autonomia della batteria.
Che vantaggio ha un approccio a chiplet rispetto a un chip monolitico? I chip monolitici integrano tutte le unità funzionali su un unico grande die di silicio. Al crescere delle dimensioni del die, il tasso di difetti di produzione aumenta in modo esponenziale, riducendo le rese e alzando i costi unitari. Un'architettura a chiplet scompone il sistema in die di silicio più piccoli e standardizzati, prodotti separatamente con rese elevate e collegati tramite micro-bump ad alta velocità. Questo consente configurazioni modulari e flessibili, adattate a specifici requisiti industriali di potenza e formato.
Chi sono i principali partner commerciali di questa tecnologia? La piattaforma di calcolo in memoria di Mythic AI si regge oggi su due grandi partnership aziendali: Lockheed Martin, che integra l'architettura in droni per la difesa tattica, piattaforme robotiche senza pilota e postazioni di sicurezza perimetrale per allungare l'autonomia delle batterie; e Honda Motor, che punta a chip IA economici e qualificati per l'automotive per la percezione dell'ambiente del veicolo e il rilevamento nell'abitacolo.
Riferimenti #
- Economist Enterprise, (2026). Summit Physical AI & Robotics: vantaggio operativo grazie ai sistemi autonomi ⧉. Economist Enterprise.
- Ozcelik, T., (2026). Oltre la legge di Moore: l'energia dietro la robotica ad alte prestazioni ⧉. Mythic AI.
- Cukier, K., (2026). I limiti termodinamici dell'intelligenza autonoma ⧉. The Economist.
- Marković, D., Mizrahi, A., Querlioz, D., e Grollier, J., (2020). La fisica per il calcolo neuromorfico ⧉. Nature Reviews Physics, 2, 499-510.
- Universal Chiplet Interconnect Express, (2025). Specifica UCIe 2.0: standard di interconnessione die-to-die ⧉. UCIe Consortium.
- IEEE, (2026). International Roadmap for Devices and Systems (IRDS): oltre il CMOS e il calcolo in memoria ⧉. IEEE Standards Association.
Ultima revisione .
Ultima revisione .
Ripubblica questo articolo
Copia il formato per Medium
# Calcolo in memoria e chiplet: la robotica oltre la legge di Moore — Sebastien Rousseau

> Originally published at [https://sebastienrousseau.com/it/2026-10-13-calcolo-in-memoria-chiplet-robotica-oltre/](https://sebastienrousseau.com/it/2026-10-13-calcolo-in-memoria-chiplet-robotica-oltre/)

Al summit Physical AI and Robotics di Economist Enterprise, Taner Ozcelik (Mythic AI) ha mostrato come calcolo in memoria e chiplet abbattono il muro della memoria.

Read the full article on sebastienrousseau.com: https://sebastienrousseau.com/it/2026-10-13-calcolo-in-memoria-chiplet-robotica-oltre/
Copia il formato per Mastodon
Calcolo in memoria e chiplet: la robotica oltre la legge di Moore — Sebastien Rousseau

Al summit Physical AI and Robotics di Economist Enterprise, Taner Ozcelik (Mythic AI) ha mostrato come calcolo in memoria e chiplet abbattono il muro della memoria.

https://sebastienrousseau.com/it/2026-10-13-calcolo-in-memoria-chiplet-robotica-oltre/
Copia formattato per LinkedIn
Calcolo in memoria e chiplet: la robotica oltre la legge di Moore — Sebastien Rousseau

Al summit Physical AI and Robotics di Economist Enterprise, Taner Ozcelik (Mythic AI) ha mostrato come calcolo in memoria e chiplet abbattono il muro della memoria.

Ecco i principali punti strategici:

- Il muro termodinamico: perché l'IA fisica non può vivere nel cloud. Nella sessione intitolata Moving past Moore’s law: the power behind high-performance robotics, Kenneth Cukier ha inquadrato il dilemma ingegneristico centrale dell'autonomia aziendale: i modelli di intelligenza…
- La tesi architetturale: il calcolo in memoria (CIM). Per risolvere il collo di bottiglia termodinamico, Mythic AI ha sviluppato una filosofia architetturale: invece di far viaggiare i dati tra unità di elaborazione e banchi di memoria separati, è la memoria stessa a…
- La strategia dei chiplet modulari. Se il calcolo analogico in memoria risolve le equazioni di energia e latenza, portare il silicio in settori commerciali molto diversi richiede flessibilità nel packaging.
- Confronto architetturale: paradigmi di calcolo per la robotica edge. Fonte: sintesi dei dati emersi dalla conversazione e delle specifiche di architettura dei semiconduttori presentate al summit Physical AI and Robotics di Economist Enterprise (Convene 200 Aldersgate, Londra, 13…

Qual è l'approccio della vostra organizzazione alle sfide descritte in questo articolo?

→ https://sebastienrousseau.com/it/2026-10-13-calcolo-in-memoria-chiplet-robotica-oltre/

#CalcoloInMemoria #MythicAi #TanerOzcelik #LeggeDiMoore #ColloDiBottigliaDiVonNeumann

Sebastien Rousseau | CC-BY-4.0
Cita questo articolo
Calcolo in memoria e chiplet: la robotica oltre la legge di Moore — Sebastien Rousseau
Al summit Physical AI and Robotics di Economist Enterprise, Taner Ozcelik (Mythic AI) ha mostrato come calcolo in memoria e chiplet abbattono il muro della memoria.
BibTeX
@online{rousseau2026calcolo,
  author  = {Rousseau, Sebastien},
  title   = {{Calcolo in memoria e chiplet: la robotica oltre la legge di Moore — Sebastien Rousseau}},
  year    = {2026},
  url     = {https://sebastienrousseau.com/it/2026-10-13-calcolo-in-memoria-chiplet-robotica-oltre/},
  urldate = {2026}
}RIS
TY  - GEN
AU  - Rousseau, Sebastien
TI  - Calcolo in memoria e chiplet: la robotica oltre la legge di Moore — Sebastien Rousseau
PY  - 2026
UR  - https://sebastienrousseau.com/it/2026-10-13-calcolo-in-memoria-chiplet-robotica-oltre/
ER  -
Vancouver
Rousseau S. Calcolo in memoria e chiplet: la robotica oltre la legge di Moore — Sebastien Rousseau. sebastienrousseau.com. 2026 Oct 13. Available from: https://sebastienrousseau.com/it/2026-10-13-calcolo-in-memoria-chiplet-robotica-oltre/
Chicago
Rousseau, Sebastien. "Calcolo in memoria e chiplet: la robotica oltre la legge di Moore — Sebastien Rousseau." sebastienrousseau.com. October 13, 2026. https://sebastienrousseau.com/it/2026-10-13-calcolo-in-memoria-chiplet-robotica-oltre/.
APA
Rousseau, S. (2026, October 13). Calcolo in memoria e chiplet: la robotica oltre la legge di Moore — Sebastien Rousseau. sebastienrousseau.com. https://sebastienrousseau.com/it/2026-10-13-calcolo-in-memoria-chiplet-robotica-oltre/
Ripubblica questo articolo
Calcolo in memoria e chiplet: la robotica oltre la legge di Moore — Sebastien Rousseau
Al summit Physical AI and Robotics di Economist Enterprise, Taner Ozcelik (Mythic AI) ha mostrato come calcolo in memoria e chiplet abbattono il muro della memoria.
Questo articolo è pubblicato con licenza Creative Commons Attribution 4.0 International. La ripubblicazione richiede l'attribuzione all'URL canonico.
Calcolo in memoria e chiplet: la robotica oltre la legge di Moore — Sebastien Rousseau

Al summit Physical AI and Robotics di Economist Enterprise, Taner Ozcelik (Mythic AI) ha mostrato come calcolo in memoria e chiplet abbattono il muro della memoria.

Originally published at https://sebastienrousseau.com/it/2026-10-13-calcolo-in-memoria-chiplet-robotica-oltre/ by Sebastien Rousseau.
Licensed under CC-BY-4.0.