
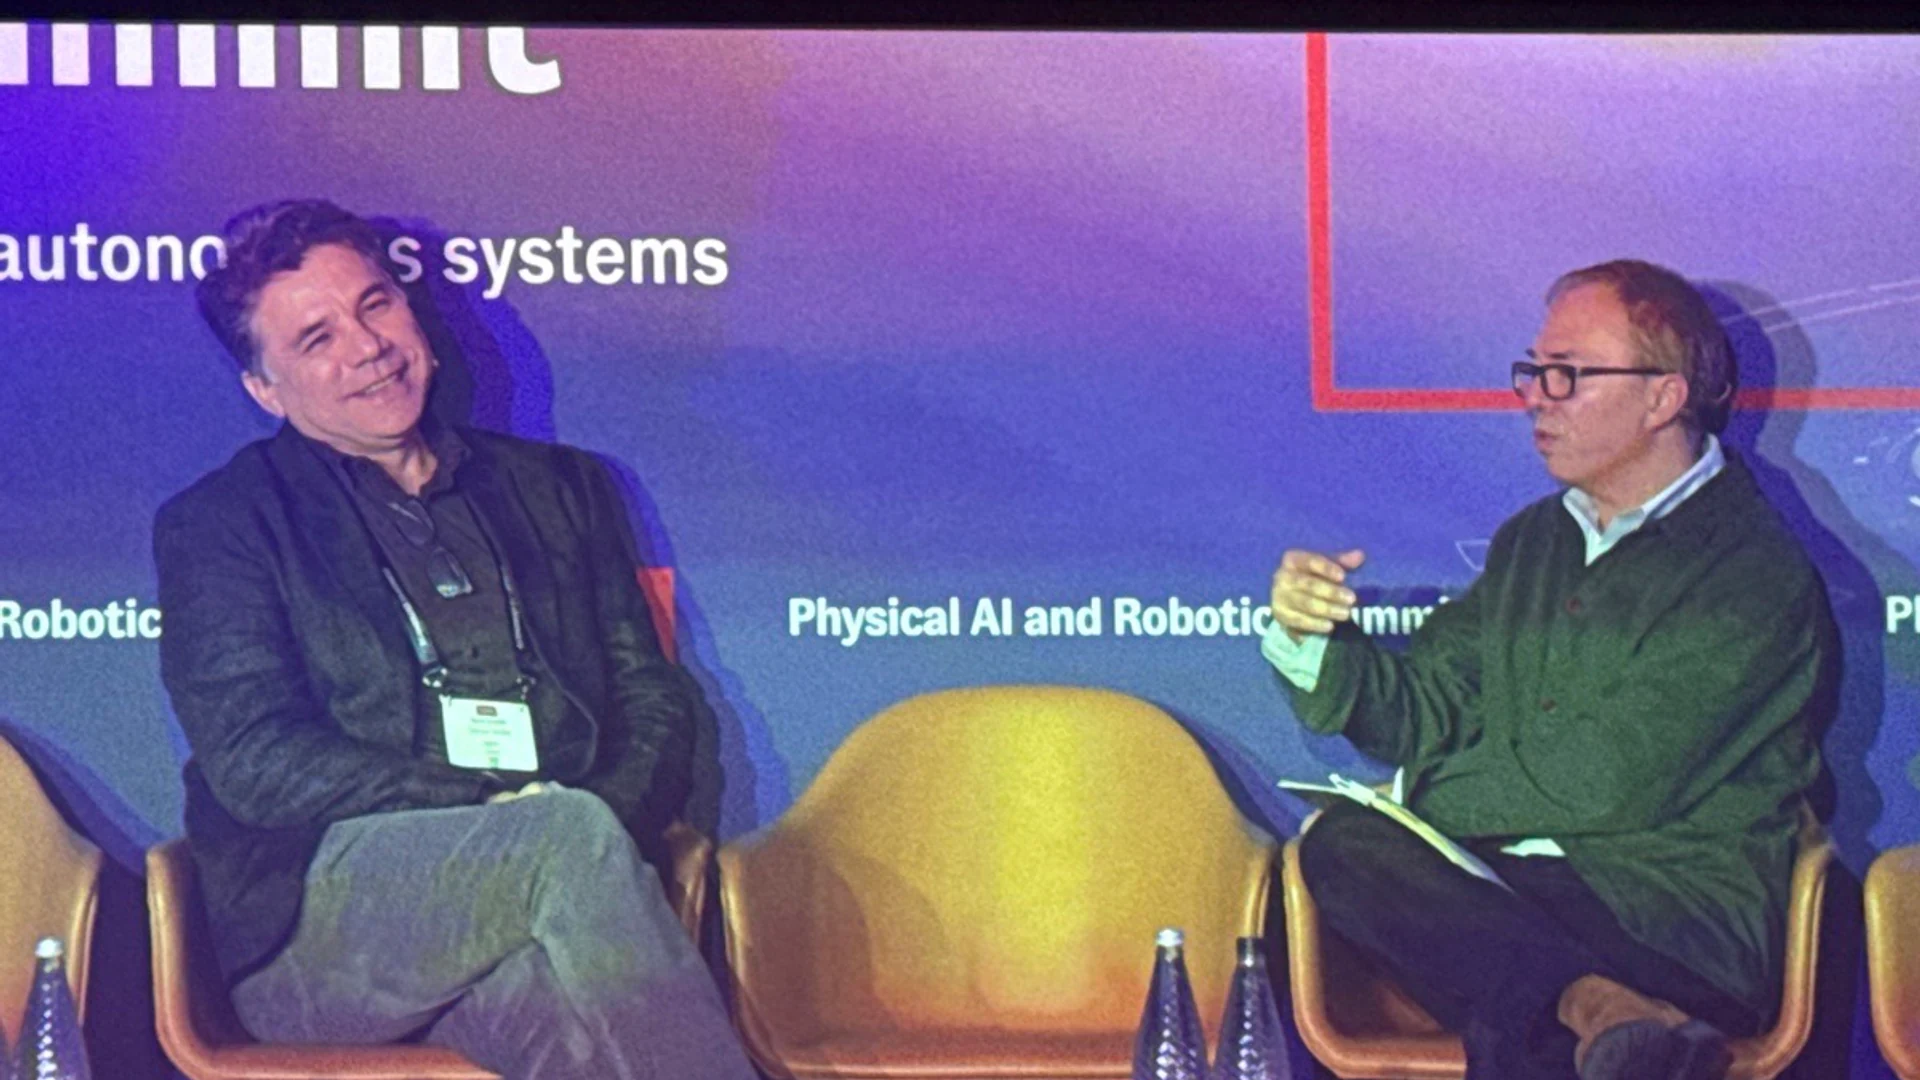
Pendant plus d'un demi-siècle, le progrès informatique a obéi à la loi de Moore : doubler le nombre de transistors gravés sur le silicium tous les dix-huit à vingt-quatre mois. Mais dans le domaine émergent de l'IA physique et de la robotique autonome, la loi de Moore s'est heurtée aux lois de la thermodynamique. Drones autonomes, robots quadrupèdes, manipulateurs chirurgicaux et véhicules autonomes ne peuvent pas embarquer des GPU de classe serveur de 700 watts ni des tours de refroidissement. Au sommet Physical AI and Robotics d'Economist Enterprise, à Londres, le 13 octobre 2026, Taner Ozcelik, président-directeur général de Mythic AI, a rejoint Kenneth Cukier pour une conversation au coin du feu consacrée à la révolution architecturale nécessaire pour sortir de cette impasse : dépasser la loi de Moore grâce au calcul analogique en mémoire (CIM) et aux chiplets modulaires.
Le mur thermodynamique : pourquoi l'IA physique ne peut pas vivre dans le cloud #
Pendant la session intitulée Moving past Moore’s law: the power behind high-performance robotics, Kenneth Cukier a posé le dilemme d'ingénierie central de l'autonomie en entreprise : les modèles d'intelligence artificielle grossissent en nombre de paramètres et en capacités de perception, mais les machines physiques fonctionnent sous d'impitoyables contraintes SWaP-C (taille, poids, puissance et coût).
La frontière actuelle de l'IA repose sur des centres de données hyperscale qui consomment 150 mégawatts ou plus à travers d'immenses grappes de serveurs. Comme l'a souligné Ozcelik, cette architecture fonctionne à des échelles d'énergie éloignées de plusieurs millions de fois des références biologiques. Le cerveau humain assure en temps réel la coordination sensorimotrice continue, le raisonnement sémantique et la navigation visuo-spatiale dans une enveloppe métabolique d'environ 20 watts.
Historiquement, les ingénieurs en robotique ont tenté de contourner les limites du calcul embarqué en déportant l'inférence vers le cloud. Mais dans les environnements industriels, aérospatiaux et de défense où la mission est critique, une autonomie dépendante du cloud est une impossibilité architecturale :
- Variance de latence et gigue : le contrôle robotique en boucle fermée à grande vitesse exige des mises à jour déterministes des moteurs entre 50 Hz et 1 000 Hz (allers-retours de moins de 20 millisecondes). Les réseaux cellulaires et Wi-Fi introduisent de la gigue, des trames perdues et des pics de latence qui font lâcher leurs pièces aux bras robotisés ou manquer leurs seuils de freinage aux véhicules autonomes.
- Saturation de la bande passante : diffuser plusieurs flux vidéo 4K non compressés et des nuages de points LiDAR depuis des dizaines de robots mobiles dans une usine épuise vite la bande passante radio locale et entraîne des frais de sortie du cloud exorbitants.
- Souveraineté opérationnelle et connectivité contestée : dans les mines souterraines, les tunnels privés de GPS, les chantiers isolés ou les théâtres militaires tactiques, les liaisons réseau externes sont inexistantes ou activement brouillées. Les systèmes autonomes doivent embarquer toute leur intelligence opérationnelle directement sur le châssis en périphérie.
Équiper les robots de GPU haute performance classiques a aussi ses pénalités physiques : bridage thermique, dissipateurs massifs qui ajoutent une masse parasite à la charge utile, et forte consommation qui fait passer l'autonomie en vol de plusieurs heures à quelques minutes.
La thèse architecturale : le calcul en mémoire (CIM) #
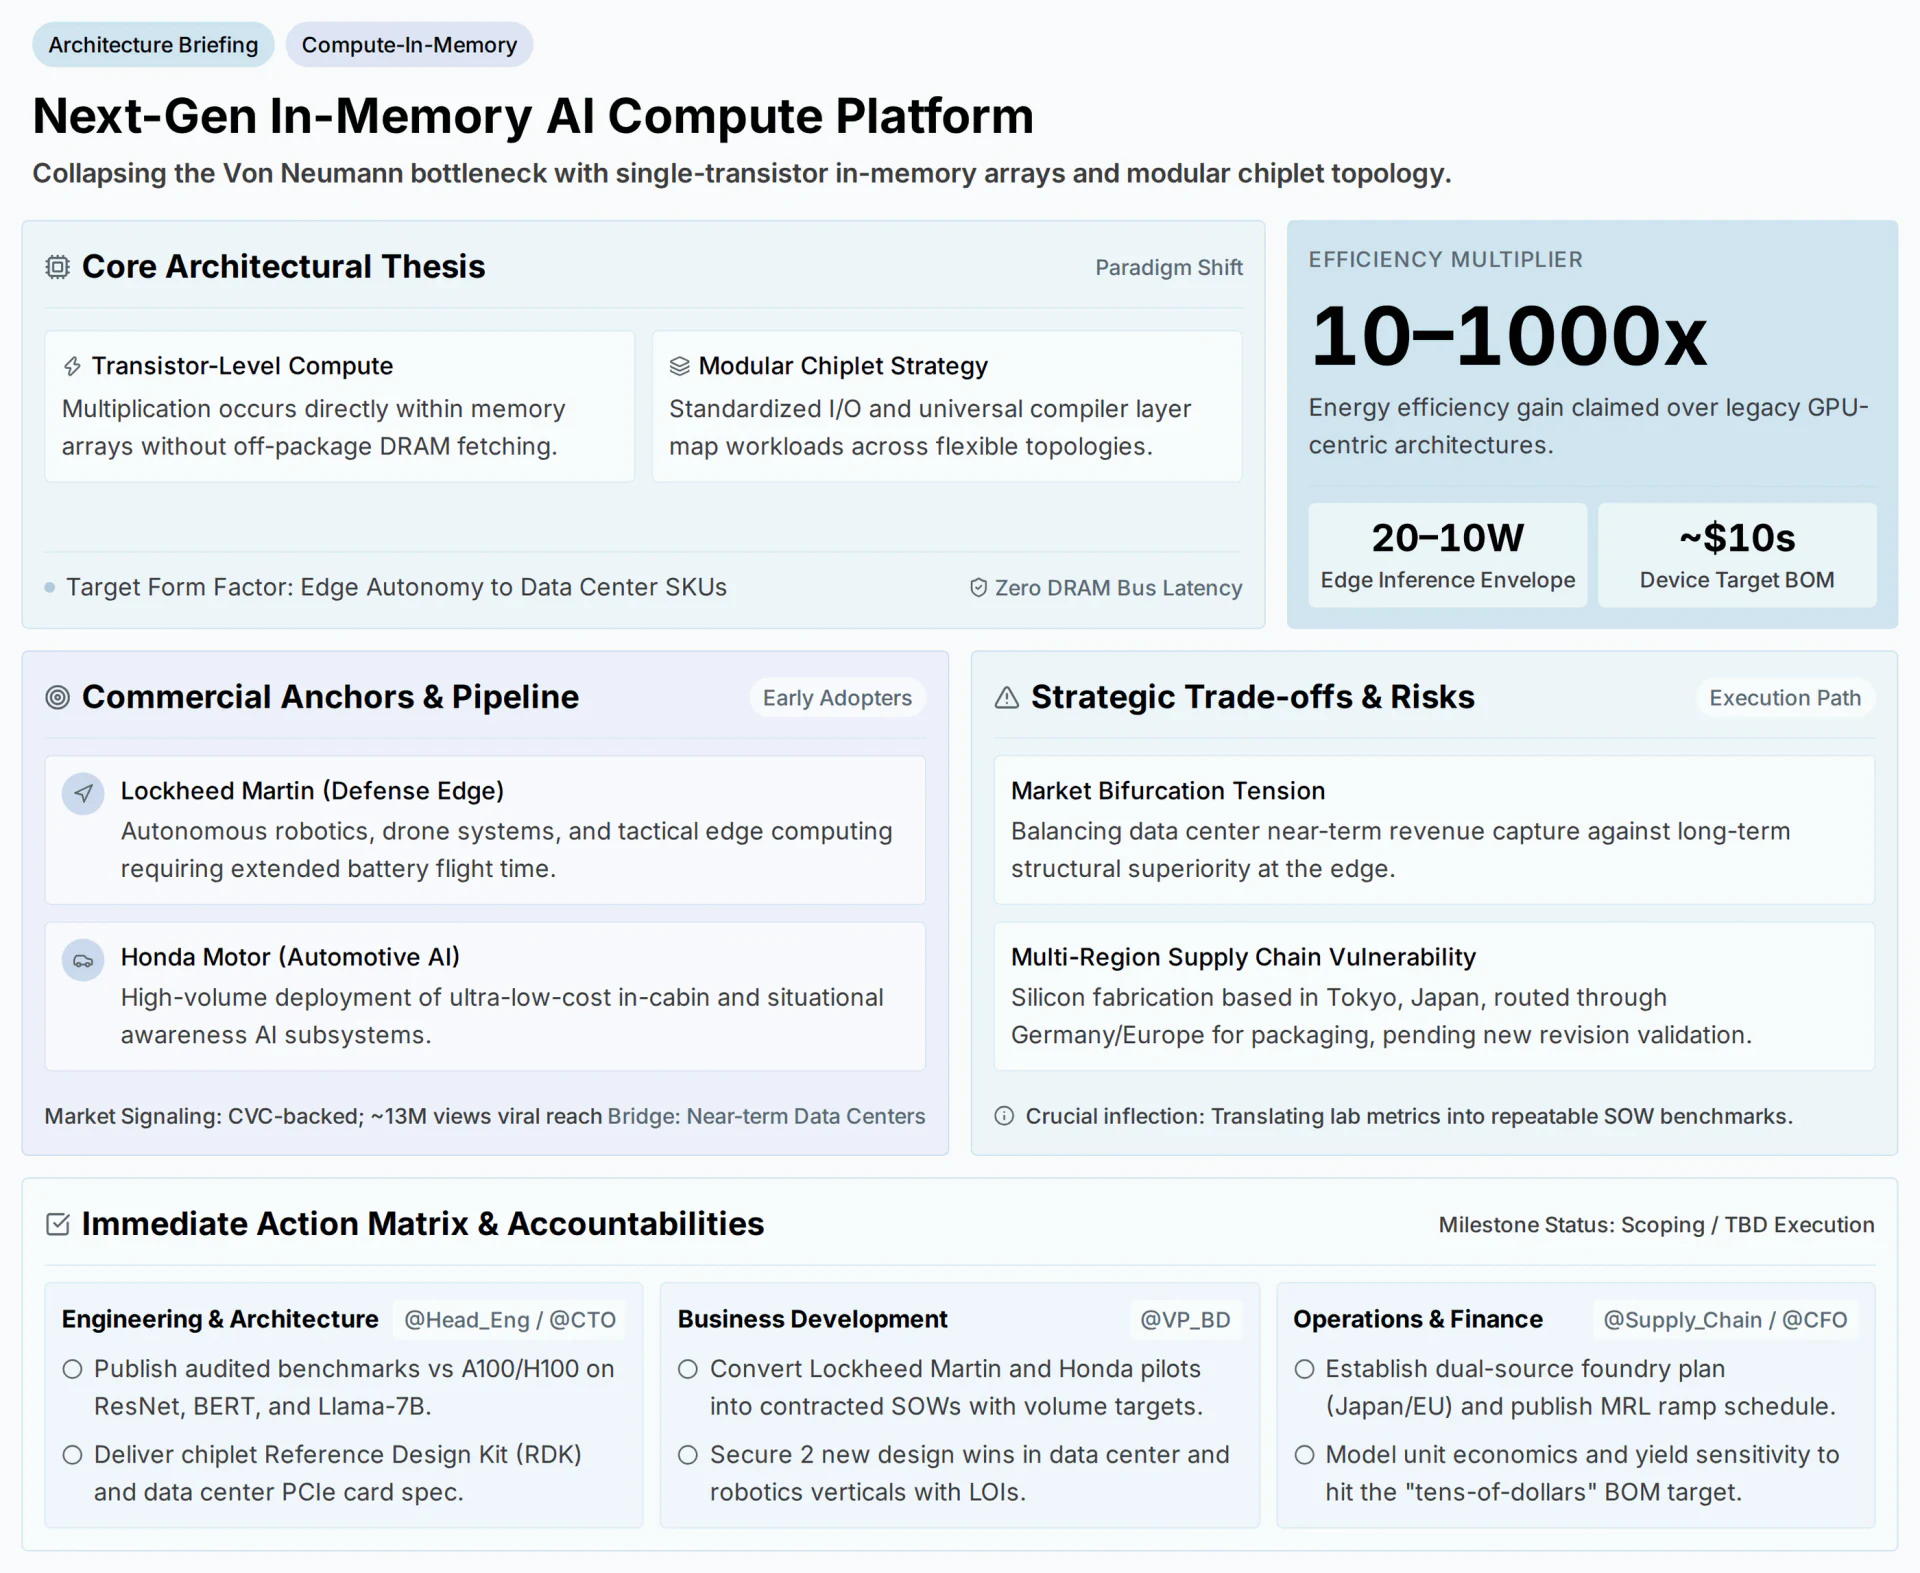
Pour résoudre le goulot thermodynamique, Mythic AI défend une philosophie architecturale : plutôt que de faire transiter les données entre des unités de traitement et des réserves de mémoire séparées, la mémoire elle-même doit devenir l'ordinateur.
 .class="img-fluid clearfix"
La physique de la multiplication matricielle à un seul transistor #
En informatique numérique classique, calculer un produit scalaire matriciel exige d'aller chercher des milliers de poids sur 8 ou 16 bits dans une DRAM externe via des lignes de bus à forte capacité, de les charger dans des registres de cache, d'effectuer la multiplication dans des ALU numériques, puis de réécrire les résultats en mémoire. Plus de 90 % de l'énergie sert à charger et décharger les interconnexions en cuivre entre les puces.
Les architectures de calcul en mémoire remplacent ce transfert numérique de données par la physique des circuits analogiques :
Programmation des poids. Les poids du réseau de neurones sont programmés directement dans des cellules de mémoire non volatile (flash modifiée ou RAM résistive, par exemple) sous forme de conductances analogiques ($G$). Une fois programmés, les poids restent fixes dans la matrice mémoire ; ils ne sont jamais lus ni transférés pendant l'inférence.
Modulation de la tension d'entrée. Les activations d'entrée (par exemple des jetons visuels issus des caméras) sont converties en niveaux de tension analogiques ($V$) et appliquées sur les lignes de mot de la matrice.
Multiplication par la loi d'Ohm. Quand la tension d'entrée traverse chaque cellule mémoire, la loi d'Ohm ($I = V \times G$) réalise une multiplication analogique instantanée et produit un courant proportionnel au produit de l'entrée et du poids stocké.
Accumulation par la loi des nœuds de Kirchhoff. Le long des lignes de bit verticales, les courants de milliers de cellules en parallèle s'additionnent naturellement selon la loi des nœuds de Kirchhoff ($\sum I = 0$).
Une seule matrice de mémoire flash exécute ainsi une multiplication matrice-vecteur complète en un seul cycle d'horloge, au niveau de la physique, sans un seul accès mémoire. Le courant analogique accumulé est ensuite reconverti en valeurs numériques par des convertisseurs analogique-numérique (CAN) rapides placés en bordure de la matrice.
La stratégie des chiplets modulaires #
Si le calcul analogique en mémoire résout les équations d'énergie et de latence, déployer le silicium dans des secteurs commerciaux variés exige de la souplesse dans l'encapsulation. Plutôt que de fabriquer de grands systèmes sur puce (SoC) monolithiques, qui souffrent de taux de défauts exponentiels, de faibles rendements par plaquette et de configurations figées, Ozcelik a présenté une stratégie de chiplets modulaires.
Dans ce paradigme, de petites tuiles de calcul en mémoire standardisées sont fabriquées séparément puis assemblées sur des interposeurs grâce à l'encapsulation avancée :
- Interconnexions puce à puce standardisées à haut débit : en s'appuyant sur des normes émergentes comme Universal Chiplet Interconnect Express (UCIe), les chiplets communiquent par micro-billes avec une forte densité de bande passante et des latences de l'ordre de la picoseconde.
- Composition hétérogène : un concepteur peut associer deux chiplets en mémoire à un processeur de contrôle ARM bon marché pour la charge utile d'un drone léger, ou assembler seize chiplets avec des interfaces PCIe rapides pour créer une carte d'accélération serveur destinée aux centres de données de périphérie.
- Compilation universelle et répartition des charges : une couche de compilation unifiée ingère des graphes d'apprentissage profond standard (ONNX, PyTorch) et répartit automatiquement les couches du modèle sur la topologie de chiplets disponible, en optimisant le routage des données pour réduire au minimum les échanges entre chiplets.
Comparaison architecturale : les paradigmes de calcul pour la robotique en périphérie #
| Critère architectural | GPU numérique standard (NVIDIA Jetson / Orin) | NPU de périphérie dédié (Google Coral / Hailo) | Chiplet de calcul analogique en mémoire (Mythic AI) |
|---|---|---|---|
| Mécanisme sous-jacent | Cœurs numériques SIMD/tenseurs qui lisent les poids en LPDDR5/HBM | Matrices systoliques numériques avec cache des poids en SRAM sur puce | Matrices analogiques à un seul transistor qui multiplient les matrices in situ |
| Coût du déplacement des données | Élevé (charge continue des bus DRAM/SRAM ; plus de 85 % d'énergie gaspillée) | Modéré (limité par la capacité du cache SRAM interne) | Aucun déplacement interne ; les poids restent en permanence en mémoire |
| Enveloppe de puissance d'inférence | 30 W à plus de 75 W (ventilation active et lourds dissipateurs nécessaires) | 5 W à 15 W (refroidissement passif ou minimal) | 10 W à 20 W (dissipation thermique passive ultra-compacte) |
| Efficacité énergétique (TOPS/W) | 2 à 5 TOPS/watt (au niveau système) | 10 à 25 TOPS/watt | 50 à plus de 200 TOPS/watt (efficacité théorique de 10x à 1 000x) |
| Nomenclature du composant (BOM) | 500 £ à plus de 2 500 £ par module de calcul | 100 £ à 350 £ par carte d'accélération | Quelques dizaines de dollars par chiplet en volume |
| Goulot mémoire (Von Neumann) | Sévère ; limité par la bande passante mémoire (Go/s à To/s) | Modéré ; limité par la capacité SRAM sur puce (Mo) | Inexistant ; la bande passante de la matrice égale celle de la matrice mémoire interne |
| Domaine de déploiement visé | Véhicules autonomes haut de gamme et robots d'inspection industrielle | Caméras intelligentes et objets IoT embarqués légers | Robotique tactile à haute fréquence, drones tactiques et IA automobile |
Source : synthèse des données de la conversation et des spécifications d'architecture des semi-conducteurs présentées au sommet Physical AI and Robotics d'Economist Enterprise (Convene 200 Aldersgate, Londres, 13 octobre 2026).
Ce que cela signifie par secteur #
La validation commerciale du calcul en mémoire dépend de sa pénétration dans des secteurs où les contraintes de puissance et de coût ont jusqu'ici bloqué le déploiement de modèles de fondation avancés.
Défense tactique et systèmes sans pilote #
Dans les applications de défense en périphérie, l'efficacité énergétique se traduit directement en capacité de survie opérationnelle et en durée de mission. Les petits systèmes aériens sans pilote (sUAS) et les rovers terrestres tactiques sont fortement limités par le poids de leur batterie. Équiper un drone de reconnaissance d'un GPU classique réduit son endurance en vol de 30 % à 50 %, simplement pour alimenter la pile de perception IA.
L'engagement stratégique de Mythic AI avec Lockheed Martin vise à intégrer le calcul en mémoire dans des systèmes tactiques en périphérie, des essaims de drones autonomes et des postes de surveillance isolés. En ramenant la consommation de calcul de 50 W à moins de 10 W, les drones tactiques allongent leur temps de vol tout en exécutant localement la classification multimodale d'objets, le traitement du signal pour la guerre électronique et l'odométrie visuo-inertielle, dans des théâtres d'opérations contestés et privés de GPS.
Perception automobile et IA d'habitacle #
Dans l'automobile, les grands équipementiers subissent une forte pression sur leurs marges. Si les véhicules électriques haut de gamme peuvent absorber le coût d'ordinateurs de conduite autonome refroidis par liquide à 2 000 £, les véhicules grand public ne le peuvent pas.
Le partenariat de Honda Motor avec Mythic AI répond à cette friction commerciale. Les constructeurs ont besoin de puces IA qualifiées pour l'automobile, produites en grand volume et coûtant quelques dizaines de dollars plutôt que quelques centaines, capables de faire tourner la surveillance du conducteur, la segmentation des objets dans l'angle mort et la perception à 360 degrés, sans circuits de refroidissement liquide complexes qui alourdissent le coût de fabrication et la complexité d'assemblage.
Centres de données industriels en périphérie et logistique mobile #
Bien que le calcul en mémoire soit optimisé pour la périphérie, Mythic mène une stratégie de passerelle délibérée en proposant des cartes d'accélération PCIe pour les centres de données de périphérie et les entrepôts logistiques. Dans les sites qui accueillent des centaines de robots mobiles autonomes (AMR), les baies de serveurs qui exécutent les modèles de coordination de flotte sont limitées par les arrivées électriques et les capacités de refroidissement. Les cartes d'accélération en mémoire permettent de multiplier le débit d'inférence local sans renforcer l'infrastructure électrique.
Résilience de la chaîne d'approvisionnement et géographie de la fabrication #
Un volet essentiel de l'intervention d'Ozcelik portait sur la souveraineté de la chaîne d'approvisionnement. L'innovation matérielle n'a aucun sens si le silicium ne peut pas être fabriqué, encapsulé et livré de façon fiable à grande échelle.
Mythic AI s'est doté d'une empreinte de fabrication internationale répartie :
- Fabrication du silicium : la production des plaquettes de calcul en mémoire est ancrée à Tokyo, au Japon, qui tire parti de l'avance japonaise dans la fabrication de semi-conducteurs de précision et de nœuds de procédé analogiques et flash éprouvés.
- Encapsulation avancée et assemblage : les plaquettes sont acheminées en Europe (plus précisément en Allemagne) pour la découpe avancée des chiplets, le collage sur substrat multi-puces et l'inspection optique automatisée.
- Validation de révision : l'entreprise achève actuellement la validation de sa dernière révision de silicium, avec pour objectif de traduire les rendements de laboratoire en cahiers des charges (SOW) reproductibles et de qualité production pour les volumes automobiles et de défense.
Cette approche multirégionale évite les vulnérabilités géopolitiques à point unique tout en offrant aux partenaires européens et asiatiques des chaînes d'approvisionnement géographiquement diversifiées.
Conclusion #
La conversation entre Taner Ozcelik et Kenneth Cukier au sommet Physical AI and Robotics d'Economist Enterprise a décrit la réalité physique qui gouvernera la prochaine décennie des systèmes autonomes. La loi de Moore, simple mesure de la miniaturisation des transistors, ne suffit plus à alimenter la révolution de l'IA physique.
Tant que les architectures de calcul resteront attachées à la séparation de Von Neumann entre logique et mémoire, la robotique restera bridée par la masse des batteries, la dissipation thermique et des coûts de nomenclature prohibitifs. En passant du déplacement numérique des données aux matrices analogiques de calcul en mémoire et aux topologies de chiplets modulaires, l'ingénierie des semi-conducteurs apporte le saut d'efficacité dont les systèmes autonomes ont besoin.
Passer de grappes de centres de données de 700 W à du silicium de périphérie de 15 W constitue la véritable porte d'entrée de l'autonomie physique. En dernière analyse, des robots qui opèrent dans le monde réel doivent obéir aux lois énergétiques du monde réel ; le calcul en mémoire est l'architecture qui comble l'écart entre le silicium et la biologie.
Foire aux questions #
Qu'est-ce que le goulot d'étranglement de Von Neumann dans le matériel d'IA ? Le goulot d'étranglement de Von Neumann désigne la limite de débit et d'énergie causée par la séparation physique entre l'unité de traitement (ALU) et la mémoire système (DRAM). Dans les charges d'intelligence artificielle, qui impliquent des milliards de multiplications matricielles, les processeurs dépensent plus de 85 % de leur énergie totale et de nombreux cycles d'horloge à faire simplement transiter des données sur des bus en cuivre, ce qui crée de sévères goulots thermiques et de latence.
Comment fonctionne le calcul analogique en mémoire (CIM) ? Le calcul en mémoire effectue les opérations mathématiques directement dans les cellules mémoire, sans déplacer les données. Les poids du réseau de neurones sont stockés sous forme d'états de conductance analogiques dans des cellules de mémoire non volatile. Lorsque des tensions d'entrée sont appliquées à la matrice, le courant traverse les cellules selon la loi d'Ohm ($I = V \times G$) et s'additionne le long des lignes de bit selon la loi des nœuds de Kirchhoff. On obtient ainsi une multiplication matrice-vecteur complète en une seule étape physique.
Pourquoi le calcul en mémoire est-il particulièrement décisif pour les robots et les drones ? Les robots mobiles et les drones fonctionnent sous de strictes contraintes de taille, de poids, de puissance et de coût (SWaP-C). Ils dépendent de batteries embarquées et ne peuvent pas porter de lourds radiateurs ni des alimentations de forte puissance. Le calcul en mémoire offre une efficacité énergétique 10 à 1 000 fois supérieure, ce qui permet aux robots d'exécuter localement des modèles vision-langage-action complexes dans une enveloppe de 10 W à 20 W tout en préservant l'autonomie de la batterie.
Quel est l'avantage d'une approche par chiplets par rapport à une puce monolithique ? Les puces monolithiques intègrent toutes les unités fonctionnelles sur une seule grande puce de silicium. À mesure que sa taille augmente, le taux de défauts de fabrication croît de façon exponentielle, ce qui réduit les rendements et augmente les coûts unitaires. Une architecture à chiplets découpe le système en petites puces standardisées, fabriquées séparément avec de hauts rendements et reliées par des micro-billes à haut débit. Cela permet des configurations modulaires et souples, adaptées aux exigences industrielles de puissance et de format.
Qui sont les principaux partenaires commerciaux de cette technologie ? La plateforme de calcul en mémoire de Mythic AI repose aujourd'hui sur deux grands partenariats : Lockheed Martin, qui intègre l'architecture dans des drones de défense tactique, des plateformes robotisées sans pilote et des postes de sécurité périmétrique afin d'allonger l'autonomie des batteries ; et Honda Motor, qui vise des puces IA bon marché, qualifiées pour l'automobile, destinées à la perception de l'environnement du véhicule et à la détection dans l'habitacle.
Références #
- Economist Enterprise, (2026). Sommet Physical AI & Robotics : l'avantage opérationnel par les systèmes autonomes ⧉. Economist Enterprise.
- Ozcelik, T., (2026). Dépasser la loi de Moore : l'énergie derrière la robotique haute performance ⧉. Mythic AI.
- Cukier, K., (2026). Les plafonds thermodynamiques de l'intelligence autonome ⧉. The Economist.
- Marković, D., Mizrahi, A., Querlioz, D., et Grollier, J., (2020). La physique au service du calcul neuromorphique ⧉. Nature Reviews Physics, 2, 499-510.
- Universal Chiplet Interconnect Express, (2025). Spécification UCIe 2.0 : norme d'interconnexion puce à puce ⧉. UCIe Consortium.
- IEEE, (2026). International Roadmap for Devices and Systems (IRDS) : au-delà du CMOS et du calcul en mémoire ⧉. IEEE Standards Association.
Dernière révision .
Dernière révision .
Republier cet article
Copier le format pour Medium
# Calcul en mémoire et chiplets : dépasser la loi de Moore en robotique — Sebastien Rousseau

> Originally published at [https://sebastienrousseau.com/fr/2026-10-13-calcul-en-memoire-chiplets-depasser-loi/](https://sebastienrousseau.com/fr/2026-10-13-calcul-en-memoire-chiplets-depasser-loi/)

Au sommet Physical AI and Robotics d'Economist Enterprise, Taner Ozcelik (Mythic AI) a montré comment le calcul en mémoire et les chiplets brisent le mur de la mémoire.

Read the full article on sebastienrousseau.com: https://sebastienrousseau.com/fr/2026-10-13-calcul-en-memoire-chiplets-depasser-loi/
Copier le format pour Mastodon
Calcul en mémoire et chiplets : dépasser la loi de Moore en robotique — Sebastien Rousseau

Au sommet Physical AI and Robotics d'Economist Enterprise, Taner Ozcelik (Mythic AI) a montré comment le calcul en mémoire et les chiplets brisent le mur de la mémoire.

https://sebastienrousseau.com/fr/2026-10-13-calcul-en-memoire-chiplets-depasser-loi/
Copier formaté pour LinkedIn
Calcul en mémoire et chiplets : dépasser la loi de Moore en robotique — Sebastien Rousseau

Au sommet Physical AI and Robotics d'Economist Enterprise, Taner Ozcelik (Mythic AI) a montré comment le calcul en mémoire et les chiplets brisent le mur de la mémoire.

Voici les principaux points stratégiques à retenir :

- Le mur thermodynamique : pourquoi l'IA physique ne peut pas vivre dans le cloud. Pendant la session intitulée Moving past Moore’s law: the power behind high-performance robotics, Kenneth Cukier a posé le dilemme d'ingénierie central de l'autonomie en entreprise : les modèles d'intelligence…
- La thèse architecturale : le calcul en mémoire (CIM). Pour résoudre le goulot thermodynamique, Mythic AI défend une philosophie architecturale : plutôt que de faire transiter les données entre des unités de traitement et des réserves de mémoire séparées, la mémoire…
- La stratégie des chiplets modulaires. Si le calcul analogique en mémoire résout les équations d'énergie et de latence, déployer le silicium dans des secteurs commerciaux variés exige de la souplesse dans l'encapsulation.
- Comparaison architecturale : les paradigmes de calcul pour la robotique en périphérie. Source : synthèse des données de la conversation et des spécifications d'architecture des semi-conducteurs présentées au sommet Physical AI and Robotics d'Economist Enterprise (Convene 200 Aldersgate, Londres, 13…

Quelle est l'approche de votre organisation face aux défis évoqués dans cet article ?

→ https://sebastienrousseau.com/fr/2026-10-13-calcul-en-memoire-chiplets-depasser-loi/

#CalculEnMémoire #MythicAi #TanerOzcelik #LoiDeMoore #GoulotD'étranglementDeVonNeumann

Sebastien Rousseau | CC-BY-4.0
Citer cet article
Calcul en mémoire et chiplets : dépasser la loi de Moore en robotique — Sebastien Rousseau
Au sommet Physical AI and Robotics d'Economist Enterprise, Taner Ozcelik (Mythic AI) a montré comment le calcul en mémoire et les chiplets brisent le mur de la mémoire.
BibTeX
@online{rousseau2026calcul,
  author  = {Rousseau, Sebastien},
  title   = {{Calcul en mémoire et chiplets : dépasser la loi de Moore en robotique — Sebastien Rousseau}},
  year    = {2026},
  url     = {https://sebastienrousseau.com/fr/2026-10-13-calcul-en-memoire-chiplets-depasser-loi/},
  urldate = {2026}
}RIS
TY  - GEN
AU  - Rousseau, Sebastien
TI  - Calcul en mémoire et chiplets : dépasser la loi de Moore en robotique — Sebastien Rousseau
PY  - 2026
UR  - https://sebastienrousseau.com/fr/2026-10-13-calcul-en-memoire-chiplets-depasser-loi/
ER  -
Vancouver
Rousseau S. Calcul en mémoire et chiplets : dépasser la loi de Moore en robotique — Sebastien Rousseau. sebastienrousseau.com. 2026 Oct 13. Available from: https://sebastienrousseau.com/fr/2026-10-13-calcul-en-memoire-chiplets-depasser-loi/
Chicago
Rousseau, Sebastien. "Calcul en mémoire et chiplets : dépasser la loi de Moore en robotique — Sebastien Rousseau." sebastienrousseau.com. October 13, 2026. https://sebastienrousseau.com/fr/2026-10-13-calcul-en-memoire-chiplets-depasser-loi/.
APA
Rousseau, S. (2026, October 13). Calcul en mémoire et chiplets : dépasser la loi de Moore en robotique — Sebastien Rousseau. sebastienrousseau.com. https://sebastienrousseau.com/fr/2026-10-13-calcul-en-memoire-chiplets-depasser-loi/
Republier cet article
Calcul en mémoire et chiplets : dépasser la loi de Moore en robotique — Sebastien Rousseau
Au sommet Physical AI and Robotics d'Economist Enterprise, Taner Ozcelik (Mythic AI) a montré comment le calcul en mémoire et les chiplets brisent le mur de la mémoire.
Cet article est sous licence Creative Commons Attribution 4.0 International. La republication nécessite l'attribution à l'URL canonique.
Calcul en mémoire et chiplets : dépasser la loi de Moore en robotique — Sebastien Rousseau

Au sommet Physical AI and Robotics d'Economist Enterprise, Taner Ozcelik (Mythic AI) a montré comment le calcul en mémoire et les chiplets brisent le mur de la mémoire.

Originally published at https://sebastienrousseau.com/fr/2026-10-13-calcul-en-memoire-chiplets-depasser-loi/ by Sebastien Rousseau.
Licensed under CC-BY-4.0.